双机模型训练:Llama3-8B
1. 演练目标与架构
本节基于单机8卡MTT S5000完成LLaMA3-8B模型的完整训练闭环,基于FP8混合精度,覆盖从容器部署到模型产出的全链路操作。
2. 环境准备:Docker容器配置
使用摩尔线程预训练容器 training-suite:v2.1.7,
容器内置MUSA SDK 4.3.8、MT Megatron-LM 0.14.0、MT DeepSpeed 0.17.2、Torch-Musa 2.7.1。
步骤1:创建并启动训练容器 注意:两台机器都要进行下面docker部署!!!
# 创建容器
sudo docker create \
    --privileged \
    --env MTHREADS_VISIBLE_DEVICES=all \
    --net host \
    -v /data/:/data/ \
    --name train \
    registry.mthreads.com/mcconline/training-suite:v2.1.7 \
    sleep infinity

# 启动并进入容器
sudo docker start train
sudo docker exec -it train bash

# 在容器里,启动ssh服务
service ssh restart
步骤2:GPU识别验证
进入容器后,验证8卡MTT S5000的识别状态与拓扑连接:
# 查看GPU硬件识别与状态
mthreads-gmi

# 验证MCCL通信能力(需已经安装mccl-test,进入目录)
# ./mccl_test
3. 训练脚本配置
步骤3:配置LLaMA3-8B训练参数
在 /home/megatron-lm-musa-patch/examples/llama3/8B/ 目录下,run_pretrain_llama3_musa.sh 已预置标准训练配置。该脚本采用参数化设计,通过命令行接收并行策略与路径配置。
脚本核心特性(已内置):
# 模型架构参数(标准LLaMA3-8B)
--num-layers 32
--hidden-size 4096
--ffn-hidden-size 14336
--num-attention-heads 32
--group-query-attention
--num-query-groups 8
--seq-length 4096
--max-position-embeddings 4096

# 启动FlashAttention加速
--use-flash-attn        # MUSA FlashAttention加速

# FP8精度设置
TRANSFORMER_ENGINE_ARGS=(
    --transformer-impl transformer_engine
    --fp8-format hybrid
    --fp8-param-gather
)
创建双机Hostfile:
cd /home/megatron-lm-musa-patch/examples/llama3
# 单机8卡配置,写入本机IP,slots=8表示使用8张GPU
echo "10.10.142.133 slots=8" > hostfile #第一行默认为master,其他行为worker
echo "10.10.142.134 slots=8" > hostfile
脚本参数说明:
执行 8B/run_pretrain_llama3_musa.sh 时需按顺序传入11个参数:
bash 8B/run_pretrain_llama3_musa.sh \
    <WORK_HOME> \          # $1: 工作根目录(自动创建checkpoints/logs子目录)
    <PATCH_HOME> \         # $2: Megatron补丁路径(/home/megatron-lm-musa-patch)
    <EXPNAME> \            # $3: 实验名称
    <HOSTFILE> \           # $4: 机器列表文件(使用上面创建的hostfile)
    <DATA_DIR> \           # $5: 数据路径前缀(自动补全.bin/.idx后缀)
    <TP_SIZE> \            # $6: 张量并行度
    <PP_SIZE> \            # $7: 流水线并行度
    <MICRO_BATCH_SIZE> \   # $8: 微批次大小
    <GLOBAL_BATCH_SIZE> \  # $9: 全局批次大小
    <TOKENIZED_MODEL>      # $10: Tokenizer路径(tokenizer.model文件)
    <RDZV_ID>              # $11: 当前时间,获取方式$(date "+%Y-%m-%d_%H:%M:%S")
4. 数据准备
步骤4:数据预处理
如果已经有Megatron预处理好的数据,可以直接使用。如果有原始数据(比如RedPajama原始JSON数据),需预处理的命令如下。这里使用SentencePieceTokenizer。
cd /home/Megatron-LM/

python tools/preprocess_data.py \
  --input /data/redpajama/arxiv_merged.jsonl \
  --output-prefix llama3 \
  --tokenizer-type SentencePieceTokenizer \
  --tokenizer-model /data/llama3-tokenizer/tokenizer.model \
  --append-eod \
  --workers 8 \
  --log-interval 50000

# 验证输出:确保存在 llama3_text_document.bin 和 llama3_text_document.idx
ls -lh ./llama3_text_document.*
如果使用SentencePieceTokenizer,需要修改 llama3/8B/ 目录下的 run_pretrain_llama3_musa.sh脚本,把 --tokenizer-type HuggingFaceTokenizer 改为 SentencePieceTokenizer 。
# 把HuggingFaceTokenizer,修改为SentencePieceTokenizer
DATA_ARGS="
    --data-path $DATA_PATH \
    --tokenizer-type SentencePieceTokenizer  \
    --tokenizer-model ${TOKENIZED_MODEL} \
    --split 1
5. 启动分布式训练
步骤5:使用分布式控制脚本启动训练
摩尔线程提供标准分布式训练控制脚本 dist_run_pretrain_megatron_llama3_musa.sh,自动完成单机/多机SSH并行下发、日志归档与参数计算。
配置并行策略参数:
编辑 dist_run_pretrain_megatron_llama3_musa.sh 顶部参数(单机8卡,双机16卡优化配置):
cd /home/megatron-lm-musa-patch/examples/llama3

# 关键参数配置
TP_SIZE=1              # 张量并行
PP_SIZE=2              # 流水线并行
WORLD_SIZE=16          # 总GPU数:双机16卡!!!!
MICRO_BATCH_SIZE=1     # 单卡微批次
NUM_MICROBATCHES=128   # 梯度累积步数

# 自动计算(无需修改)
(( DP_SIZE = $WORLD_SIZE / ($TP_SIZE * $PP_SIZE) ))  # 结果=4
(( GLOBAL_BATCH_SIZE = $MICRO_BATCH_SIZE * $NUM_MICROBATCHES * $DP_SIZE ))  # 结果=512

# 配置数据路径,Hostfile,Tokenizer
DATA_PATH=/data/datasets/llama3_text_document
HOSTFILE=./hostfile
TOKENIZED_MODEL=/data/llama3-tokenizer/tokenizer.model
脚本工作机制:
- 自动生成带时间戳的输出目录
./output/YYYY-MM-DD_HH:MM:SS/ - 通过SSH并行下发到hostfile中所有节点
- 为每个节点生成独立日志:
$EXPNAME.log.$COUNT.$host
启动命令:
cd /home/megatron-lm-musa-patch/examples/llama3

# 后台启动分布式训练,仅在master中启动即可
nohup bash dist_run_pretrain_megatron_llama3_musa.sh &
6. 训练监控
步骤6:实时监控训练状态
脚本自动创建带时间戳的日志目录,实时监控命令如下(可以分别看master和worker机器):
cd /home/megatron-lm-musa-patch/examples/llama3

# 进入最新日志目录(按时间排序取最新)
LATEST_LOG=$(ls -td ./output_log/*/ | head -n 1)
echo "Latest log dir: $LATEST_LOG"

# 实时监控主节点日志(Rank 0)
tail -f ${LATEST_LOG}/tp1_pp2_dp4_mbs1_numbs128_gbs512_gpus8/none_j0dk_fd3/attempt_0/0/stdout.log
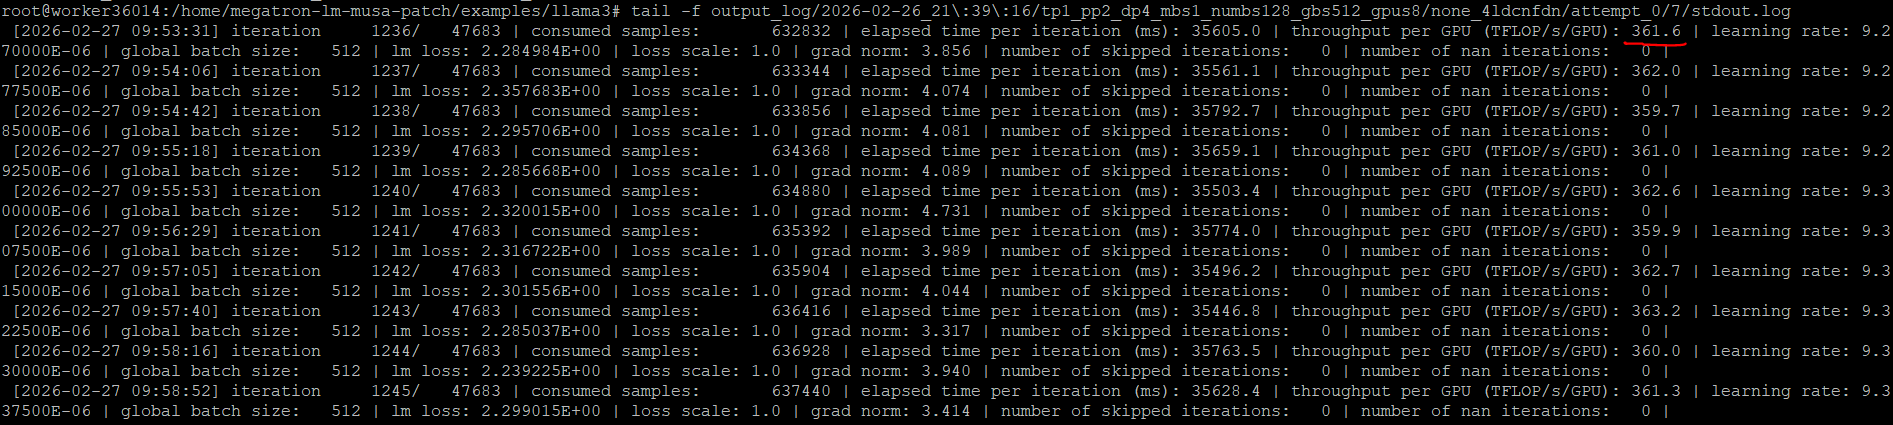
关键监控指标:
- 迭代信息:
iteration 100/100000 | loss: 7.2345 | throughput: 12.34 samples/s - 显存占用:
reserved: 37656.0 | max reserved: 37656.0(应<80GB/卡) - 时间戳:每行前缀
[2026-02-13 14:30:27]
停止训练任务:
必须使用分布式停止脚本终止所有进程,避免残留进程占用显存:
cd /home/megatron-lm-musa-patch/examples/llama3

# 执行停止
bash stop_all.sh

mthreads-gmi  # 验证显存占用接近0MB
7. 性能优化
当前并行策略为:TP=1,PP=2,DP=4, GBS=512;
优化并行策略,改为TP=1,PP=1,DP=8, GBS=1024。
启动训练后,从日志里可以看到,训练单卡有效算力有了明显提升 。
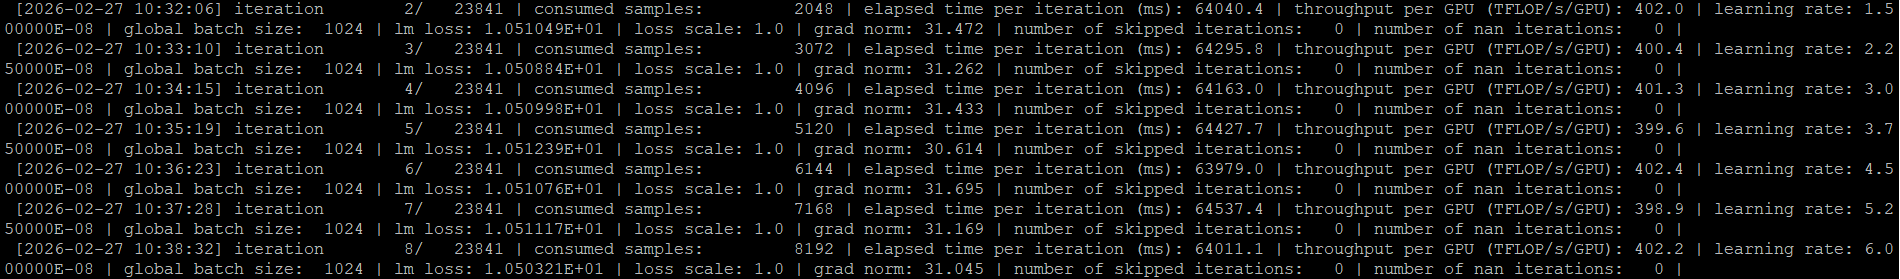
注:采用PP=1,需修改 8B/run_pretrain_llama3_musa.sh脚本,去掉 --decoder-last-pipeline-num-layers 14。