8. MCCL加速GPU通信
8.1. MCCL简介
摩尔线程集合通信库 (MCCL) 可实现针对摩尔线程GPU 和网络进行性能优化的多 GPU 和多节点通信基元。MCCL 提供了 all-gather、all-reduce、broadcast、reduce、reduce-scatter、point-to-point send 和 receive 等原语,这些原语均经过优化,可通过节点内的 PCIe 和 MTLink 高速互联以及节点间的InfiniBand网络实现高带宽和低延迟。
MCCL支持节点内和跨节点通信。可以实现拓扑的自动检测,计算最佳的路径,最终实现GPUs之间的高效传输
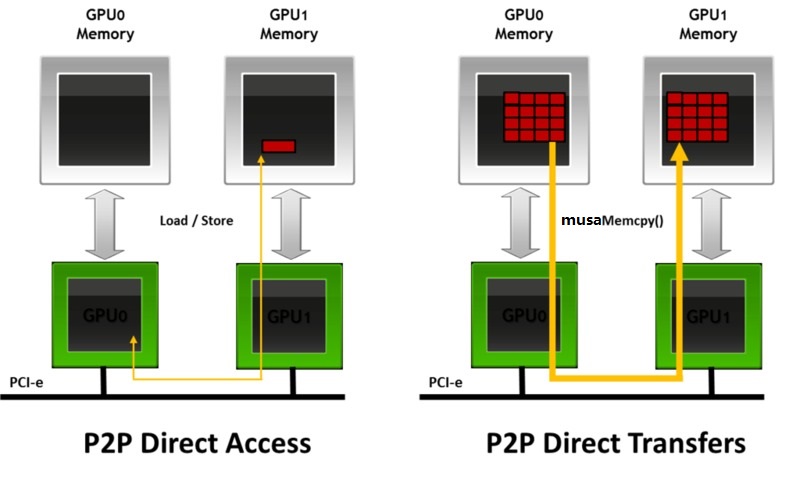
图1 MCCL框架图
8.1.1. 节点内
节点内 GPU 之间进行数据传输,主要的物理介质是 PCIe 和 MTLink,涉及到的主要技术有 GPUDirect P2P,GPUDirect P2P 避免数据通过 CPU 进行中转,降低延时,同时可以利用 GPU 高速互联的带宽。具体原理见下图
图2 显示PCIe的P2P示意图
8.1.2. 跨节点
节点间 GPU 进行数数据,主要的物理介质有普通以太网或者 InfiniBand,涉及的技术有 GPUDirect RDMA,具体原理见下图
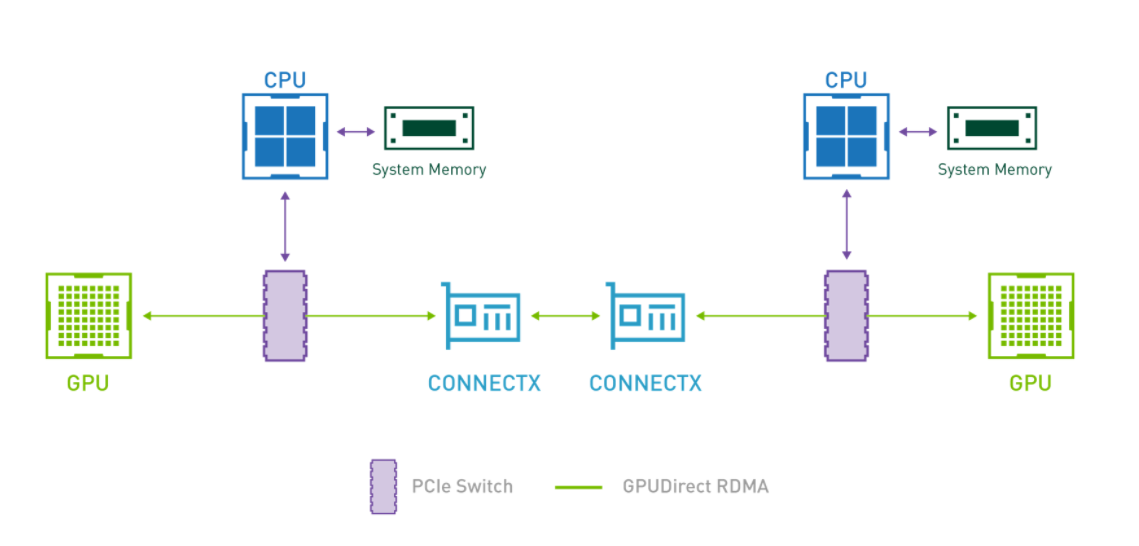
图3 跨节点传输
8.2. MCCL支持的集合通信
8.2.1. Broadcast
广播操作将数据从一个 GPU (根 GPU) 分发到所有 GPU。 所有 GPU 的内容和跟 GPU 的内容一致。
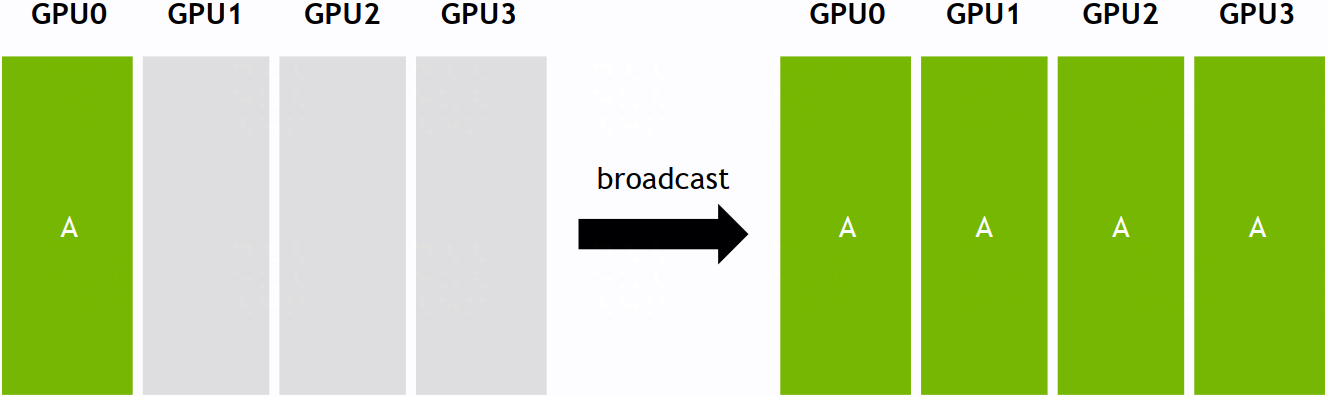
图4 broadcast运算示意图
8.2.2. Reduce
Reduce 把所有 GPU 的数据聚合到一个GPU,并对数据进行指定的规约操作。 所有GPU必须发送同等大小的数据。 此外,数据必须以能够执行 reduce 操作的方式进行对齐。 MCCL 支持四种操作: Sum, Product, Max, Min,Average。所有GPU规约计算的结果会压缩到跟GPU。
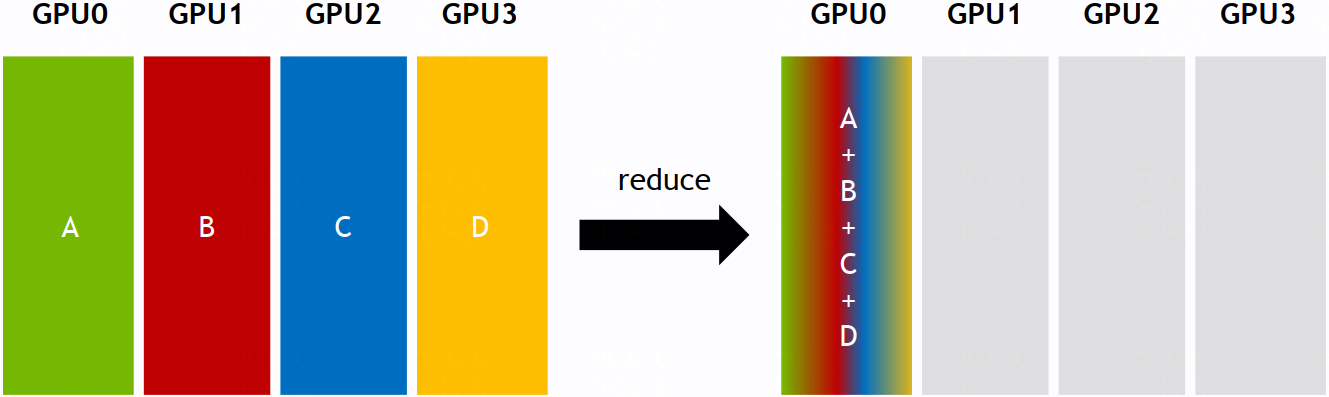
图5 Reduce运算示意图
8.2.3. AllGather
All Gather 收集所有 GPU 的数据,并发送到所有 GPU。所有发送的数据块大小必须相同。目的GPU的数据由每个GPU组合而成。
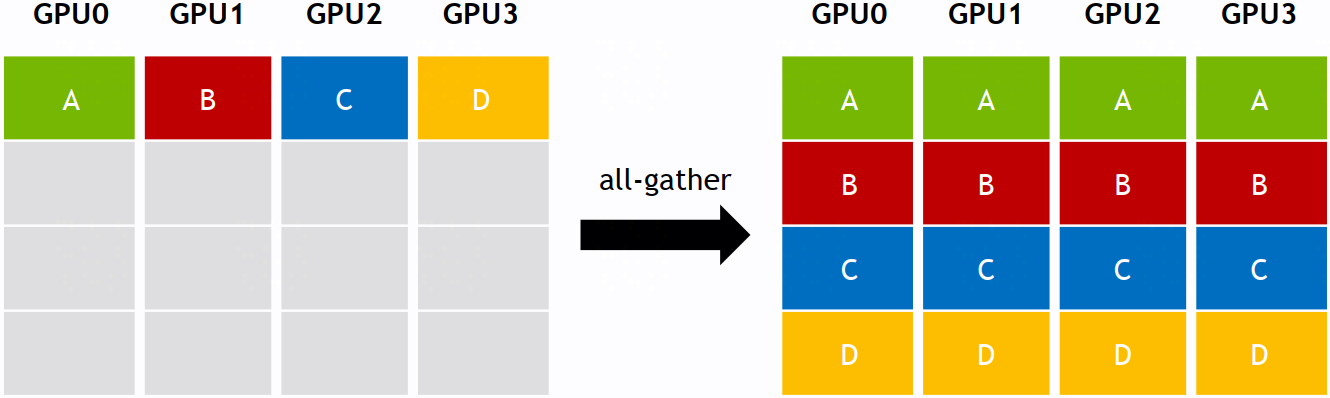
图6 AllGather运算示意图
8.2.4. AllReduce
All Reduce 的操作和 Reduce 一样, 但是需要向所有GPU发送相同的数据。
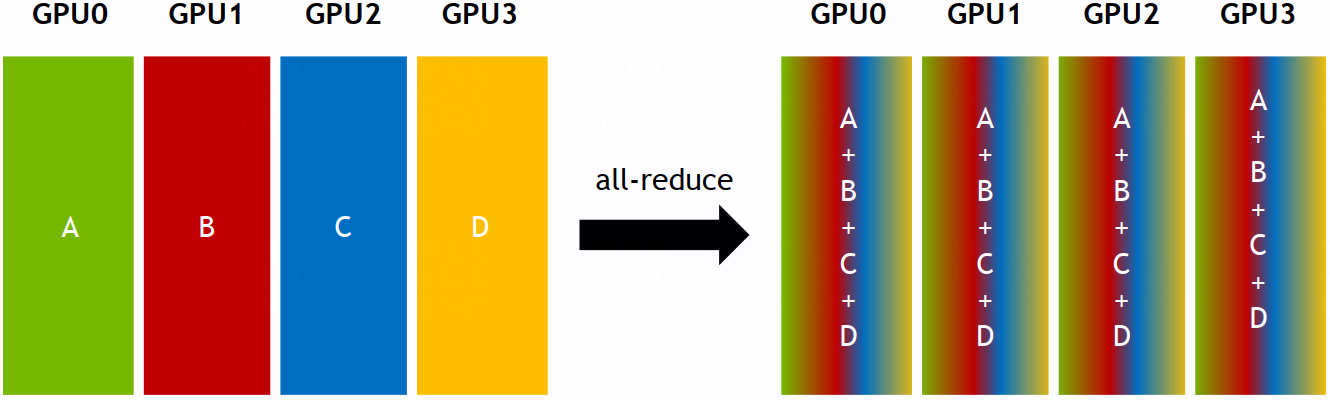
图7 AllReduce运算示意图
8.2.5. Reduce Scatter
Reduce Scatter 操作和 All Reduce 类似,不同的是最终发送到所有GPU上的一列
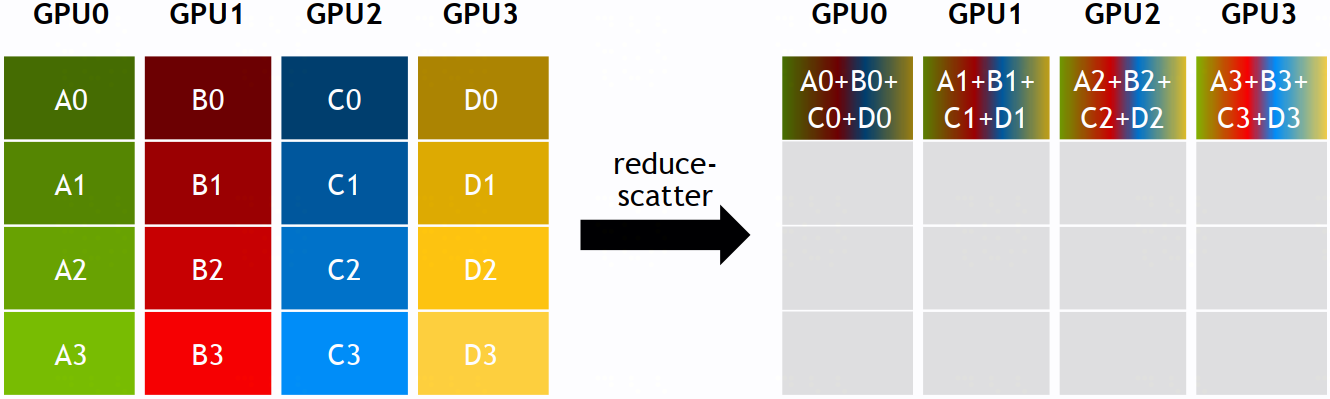
图8 Reduce Scatter运算示意图
8.3. MCCL的使用实例
8.3.1. 单线程多卡
下面的例子展示单线程使用 MCCL 进行多卡计算,将多卡的算力充分利用起来。
#include <stdio.h>
#include "musa_runtime.h"
#include "mccl.h"

#define MUSACHECK(cmd) do {                         \
  musaError_t err = cmd;                            \
  if (err != musaSuccess) {                         \
    printf("Failed: Cuda error %s:%d '%s'\n",       \
        __FILE__,__LINE__,musaGetErrorString(err)); \
    exit(EXIT_FAILURE);                             \
  }                                                 \
} while(0)


#define MCCLCHECK(cmd) do {                         \
  mcclResult_t res = cmd;                           \
  if (res != mcclSuccess) {                         \
    printf("Failed, MCCL error %s:%d '%s'\n",       \
        __FILE__,__LINE__,mcclGetErrorString(res)); \
    exit(EXIT_FAILURE);                             \
  }                                                 \
} while(0)


int main(int argc, char* argv[])
{
  mcclComm_t comms[4];

  //managing 4 devices
  int nDev = 4;
  int size = 32*1024*1024;
  int devs[4] = { 0, 1, 2, 3 };


  //allocating and initializing device buffers
  float** sendbuff = (float**)malloc(nDev * sizeof(float*));
  float** recvbuff = (float**)malloc(nDev * sizeof(float*));
  musaStream_t* s = (musaStream_t*)malloc(sizeof(musaStream_t)*nDev);


  for (int i = 0; i < nDev; ++i) {
    MUSACHECK(musaSetDevice(i));
    MUSACHECK(musaMalloc(sendbuff + i, size * sizeof(float)));
    MUSACHECK(musaMalloc(recvbuff + i, size * sizeof(float)));
    MUSACHECK(musaMemset(sendbuff[i], 1, size * sizeof(float)));
    MUSACHECK(musaMemset(recvbuff[i], 0, size * sizeof(float)));
    MUSACHECK(musaStreamCreate(s+i));
  }


  //initializing MCCL
  MCCLCHECK(mcclCommInitAll(comms, nDev, devs));


  //calling MCCL communication API. Group API is required when using
  //multiple devices per thread
  MCCLCHECK(mcclGroupStart());
  for (int i = 0; i < nDev; ++i)
    MCCLCHECK(mcclAllReduce((const void*)sendbuff[i], (void*)recvbuff[i], size, mcclFloat, mcclSum,
        comms[i], s[i]));
  MCCLCHECK(mcclGroupEnd());

  //synchronizing on CUDA streams to wait for completion of MCCL operation
  for (int i = 0; i < nDev; ++i) {
    MUSACHECK(musaSetDevice(i));
    MUSACHECK(musaStreamSynchronize(s[i]));
  }

  //free device buffers
  for (int i = 0; i < nDev; ++i) {
    MUSACHECK(musaSetDevice(i));
    MUSACHECK(musaFree(sendbuff[i]));
    MUSACHECK(musaFree(recvbuff[i]));
  }

  //finalizing MCCL
  for(int i = 0; i < nDev; ++i)
      mcclCommDestroy(comms[i]);

  printf("Success \n");
  return 0;
}
MCCL 还有其他的使用方式,如:多线程(每个 GPU 使用一个线程)和多进程模型(MPI 与 GPU 上的多线程操作相结合)。具体可以参考MCCL的文档。
8.4 FAQ
8.4.1 多卡编程时,多任务并行因 GPU 资源竞争,导致死锁,提示 GPU Overrun Error
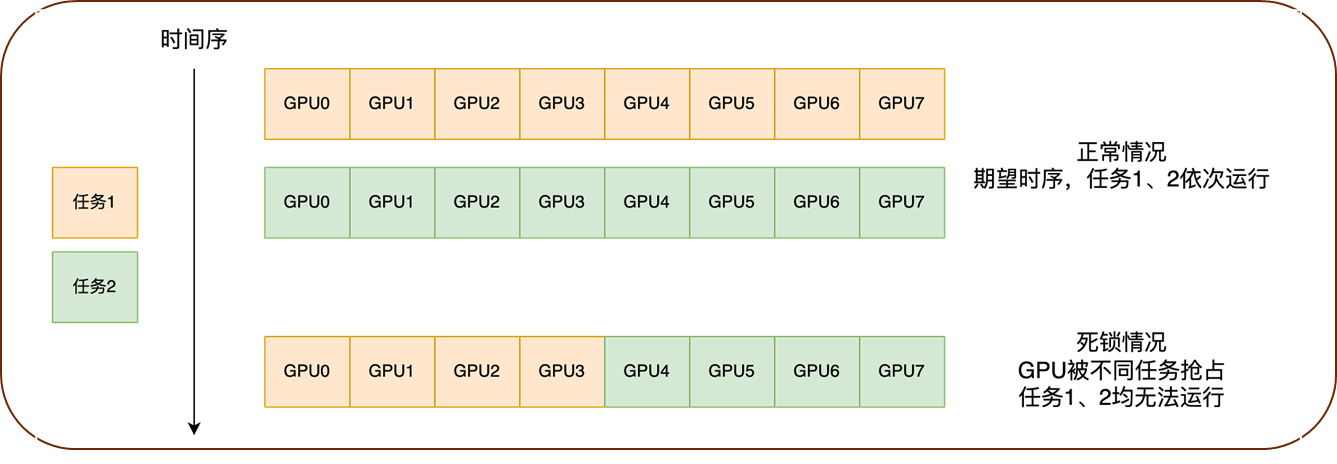
错误描述:多个任务并行,每个任务同时使用多卡进行分布式计算或通信,且必须进行多卡间同步时,有可能发生因 GPU 计算资源竞争而导致的死锁。比如任务 1 和任务 2(可以是 process、thread、stream)都同时使用 GPU0-7 进行计算或通信,每个 Step 都需要进行一次 8 卡同步,则有可能出现以下死锁情景:
- 任务 1 优先抢占到 GPU 0、1、2、3 资源,成功启动 Kernel1,但在 GPU 4、5、6、7 上,Kernel1 等待调度,同步被阻塞。
- 任务 2 优先抢占到 GPU 4、5、6、7 资源,成功启动 Kernel2,但在 GPU 0、1、2、3 上,Kernel2 等待调度,同步被阻塞。
解决方法:应用侧保证各 GPU 上的调度时序,以确保任务 1 或任务 2 同时在所有 GPU 上被优先调度。具体如下:
- 任务 1 及任务 2,在同一块 GPU 上,使用同一个 musa stream 以保证 kernel 调度串行化,同时所有 GPU 上,使用相同的调度时序,即 Kernel1 - Kernel2 或 Kernel2 - Kernel1。
- 在不同任务间添加 barrier,确保任务间串行占用 GPU 资源,即任务 1 - 设备同步 - 任务 2。