【中级】部署 Dify 本地知识库
更新日志
| 版本 | 日期 | 变更描述 |
|---|---|---|
| 1.0.0 | 2026-03-04 | 初始版本,包含在 AI 算力本 MTT AIBOOK(型号 A141)上安装和配置构建本地知识库环境依赖,以及配置本地知识库的完整指南 |
| 1.0.1 | 2026-08-10 | 更新对 vLLM 环境部署的相关描述。 |
1. 项目简介
本教程旨在指导开发者在 AI 算力本 MTT AIBOOK 上基于 Dify 和本地大模型搭建自己的本地个人知识库。您可以基于本项目的内容,学会把自己的个人资料、过往输出文章、日记等所有个人信息上传到本地知识库,打造自己的私人助理。
本项目将按照以下主线展开:
- 安装 docker
- 安装 docker-compose
- 部署 Ollama
- 部署 vLLM
- 部署 Dify
- 创建 Dify 应用
- 创建 Dify 知识库
- 将本地模型接入 Dify 工作流
并最终结合最佳实践,带您快速上手完成本地个人知识库的搭建。
docker 简介: Docker 为 Dify 提供了一键式的容器化部署方案。它将 Dify 及其所需的数据库、中间件等组件完整打包,确保应用在不同服务器上都能实现"开箱即用"的一致性体验。
Ollama 简介: Ollama 是一个用于在本地设备上运行大语言模型的工具,可以一键下载并运行如 Llama、Qwen、Mistral 等模型。它让本地部署 AI 变得非常简单,适合个人开发者或企业在本地环境运行 AI。值得注意的是,当前在 MTT AIBOOK 上,Ollama 暂未支持 GPU 加速,只能使用 CPU 推理。本文档将基于 Ollama 运行文本向量化模型。
vLLM 简介: vLLM 是一个高性能的大模型推理框架,专门用于部署和服务大语言模型。它通过 PagedAttention 等优化技术显著提升推理吞吐量和显存利用率,当前在 MTT AIBOOK 已支持基于 vLLM 对推理过程进行 GPU 加速。本文档将基于 vLLM 运行大语言模型。
Dify 简介: Dify 是一个开源的 AI 应用开发平台,可以通过可视化方式快速构建 AI 助手、RAG 知识库、AI 工作流等应用。它支持接入多种大模型,并提供完整的应用管理和数据管理能力。
难度:中级,适合有编程基础的开发者体验
2. 前置条件
在开始本教程之前,请确保您已满足以下所有条件:
- 硬件要求:
- AI 算力本 MTT AIBOOK,型号 A141
- 网络连接(用于拉取 docker 镜像、下载模型及依赖包)
- 充足的存储空间
- 软件要求:
- MTT AIBOOK 操作系统 AIOS(1.3.3-B17)及以上版本(文档基于 1.3.3-B17 版本系统操作,并非强制性要求必须 1.3.3-B17 及以上版本)
- 已安装 docker-compose(可通过本教程中的步骤进行安装)
- 已安装 Ollama(可通过本教程中的步骤进行安装)
3. 环境部署
本章节将详细描述如何创建工作目录、安装 docker、安装 docker-compose、通过 Ollama 拉取向量模型并推理、通过 vLLM 基于 GPU 加速推理大模型、部署 Dify、创建 Dify 应用、创建 Dify 知识库并最终将本地模型接入 Dify 工作流。
3.1 创建工作目录
创建一个专门用于本地知识库搭建的工作目录,有助于您更好地管理相关文件和资源。
执行以下命令即可完成工作目录的创建:
mkdir ~/local-know-base && cd ~/local-know-base
3.2 安装 docker
若您的设备已安装过 docker,可跳过此步骤。
执行以下命令即可完成 docker 的安装:
sudo apt update
sudo apt-get install \
    docker.io=24.0.7-0ubuntu2~22.04.1 \
    containerd=1.7.2-0ubuntu1~22.04.1
执行完以下命令后,需要重启设备生效:
sudo usermod -aG docker $USER
以上操作全部执行完毕后,可以执行以下命令验证 docker 是否成功安装:
docker --version

3.3 安装 docker-compose
docker-compose 是一个用于定义和运行多容器 Docker 应用程序的工具,它可以帮助我们更方便地管理 Dify 的容器化部署。
sudo curl -L "https://github.com/docker/compose/releases/download/v2.24.6/docker-compose-linux-aarch64" -o /usr/local/bin/docker-compose
sudo chmod +x /usr/local/bin/docker-compose
3.4 安装 Ollama
sudo apt install curl
curl -fsSL https://ollama.com/install.sh | OLLAMA_VERSION=0.15.1 sh
安装完成后,打开终端,输入以下命令确认版本:
ollama --version
如果输出为 ollama version is 0.15.1,说明安装成功。
3.5 拉取向量模型 nomic-embed-text
向量模型 nomic-embed-text 用于将文档内容转换为向量表示,以便进行语义搜索和相似度计算。拉取该模型是构建本地知识库的必要步骤。
ollama pull nomic-embed-text
3.6 部署 vLLM
本文档将基于 vLLM 进行本地大模型的推理,因此需要安装部署 vLLM 及其相关依赖的环境,在确认 MTT AIBOOK 的系统版本后,根据以下链接的网页跳转到对应系统版本的安装部署指导文档,部署正确的 vLLM 及其环境依赖:
https://docs.mthreads.com/vllm-musa-m1000/vllm-musa-m1000-doc-online/AIBook/
根据文档指引部署成功后,即可进行下一步。
注意:AIOS 1.5.0 及以上版本,相关的 vLLM 及 vLLM 依赖环境将由系统自动更新,而无需用户手动更新。
3.7 部署 Dify
首先,克隆 Dify 官方开源仓库到工作目录:
cd ~/local-know-base
git clone https://github.com/langgenius/dify.git
Dify 使用 .env 文件管理配置。我们通过复制示例文件来创建它:
cd ~/local-know-base/dify/docker
cp .env.example .env
由于我们只是将 Dify 运行在本地,因此无需修改 .env 文件的任何内容。
随后,我们使用 docker-compose 在后台启动 .env 文件中记录的所有相关服务(包括数据库、向量数据库、API 和 Web 前端):
docker-compose up -d
注:此步骤会从 Docker Hub 拉取多个镜像,耗时取决于网络带宽。
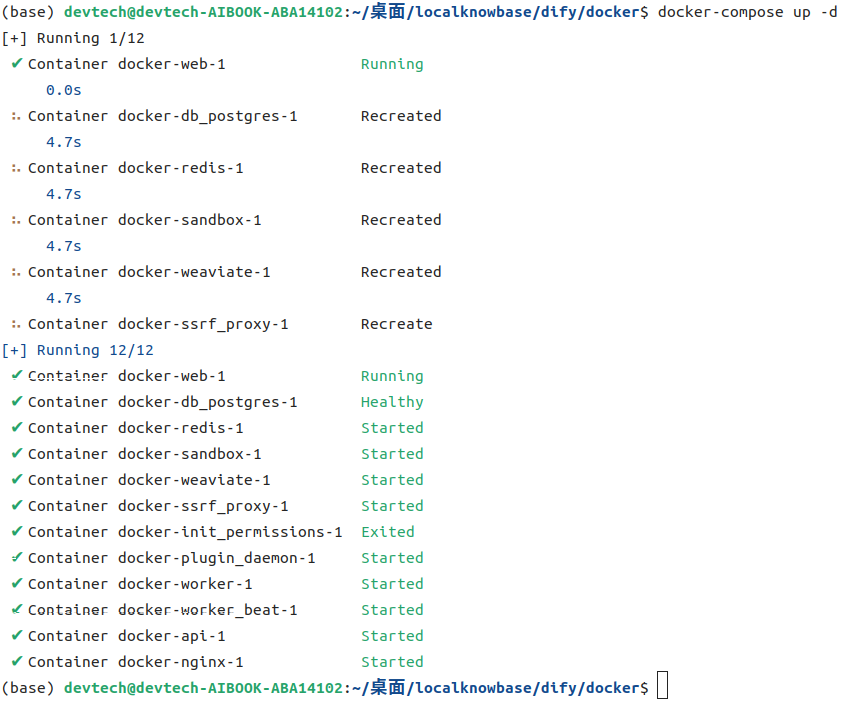
镜像拉取结束后,打开浏览器,输入网址:http://localhost
即可进入本地部署的 Dify 界面,首次进入页面,系统会提示您设置管理员邮箱、用户名和密码。
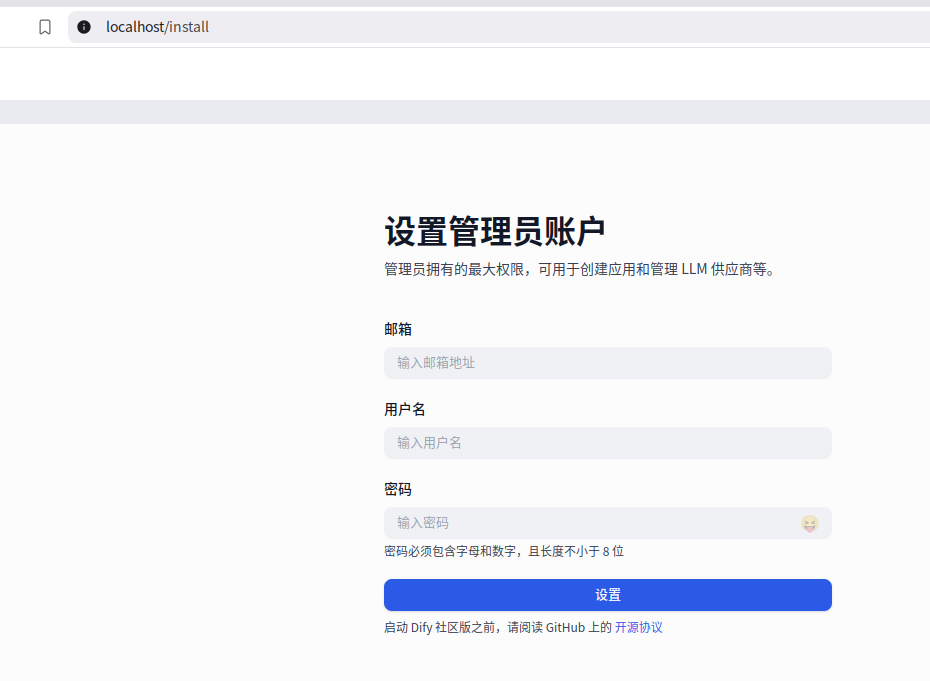
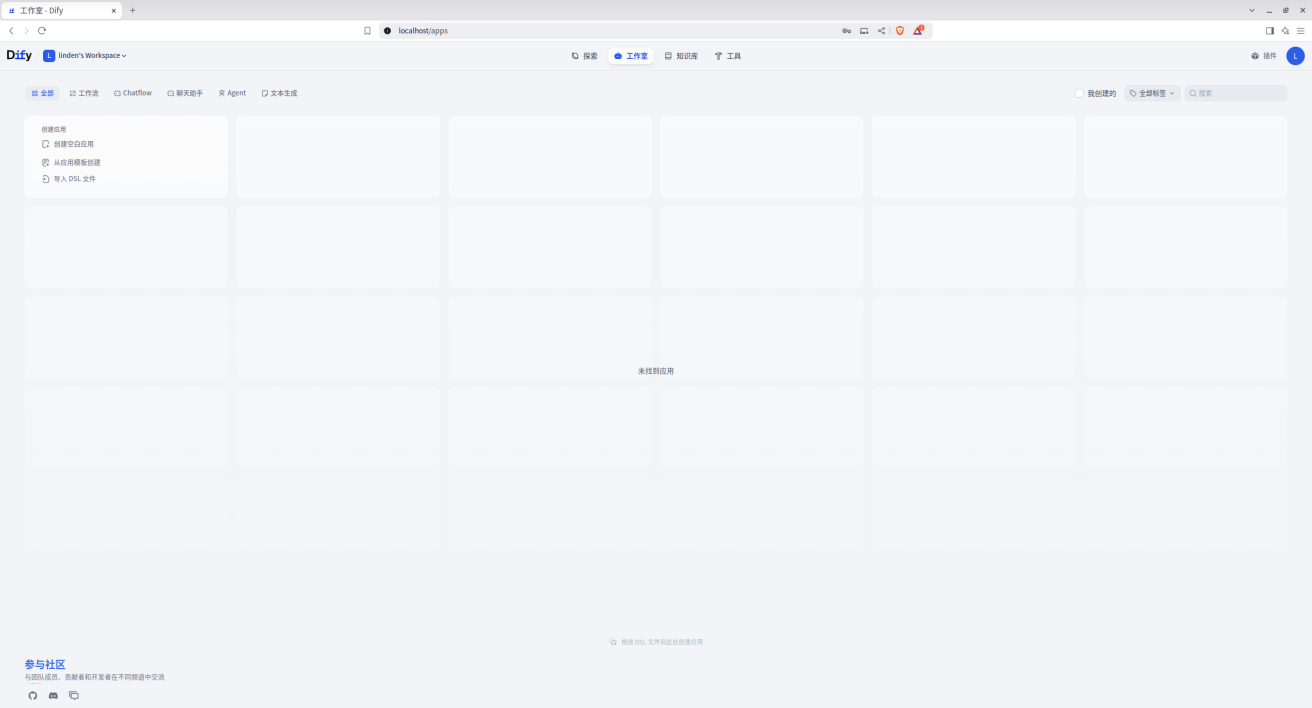
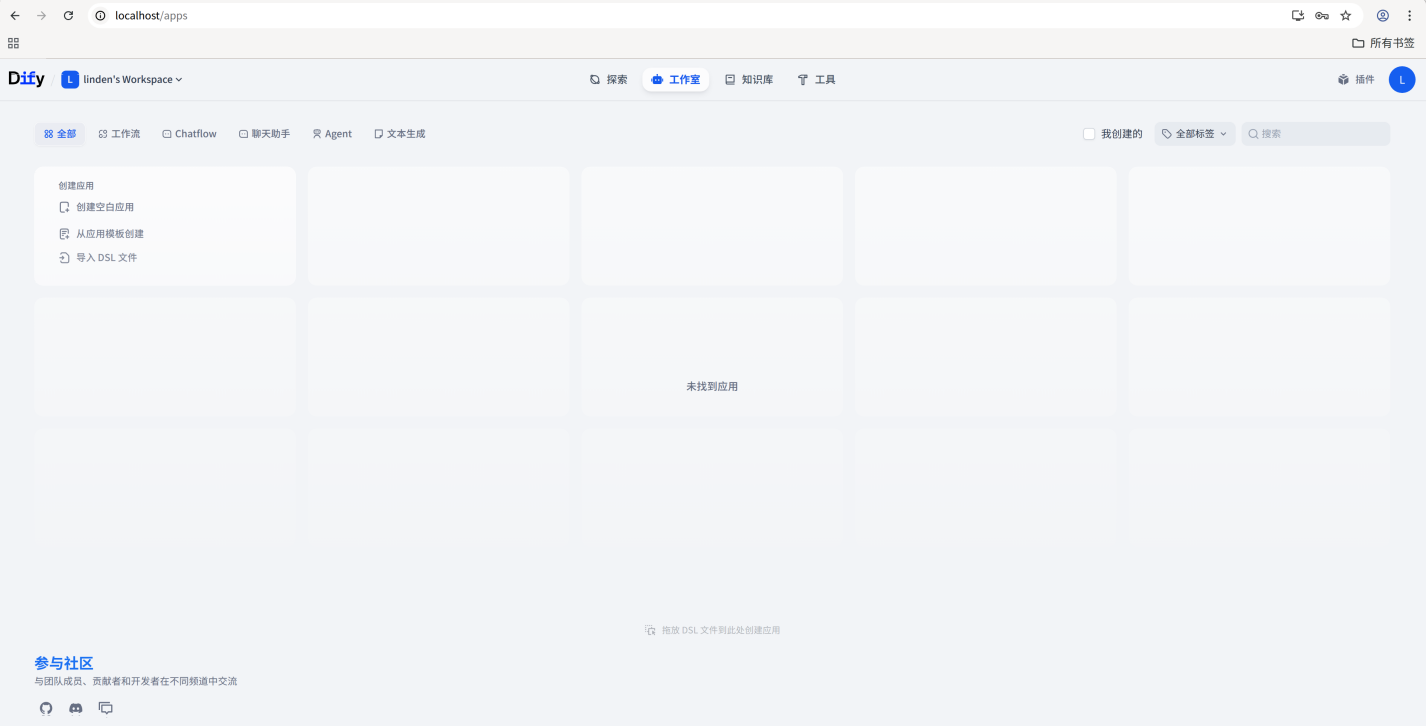
注册成功后,登录管理员账户,进入 Dify 主界面,如下所示:
3.8 使 Ollama 服务能够接受来自 Dify 的连接请求
由于 Ollama 默认只监听 127.0.0.1,如果不配置 Ollama 服务使其能够接受来自外部网络的连接请求,可能会导致 Dify 无法正常向 Ollama 发起请求。
打开终端后,执行:
sudo mkdir -p /etc/systemd/system/ollama.service.d && \
echo '[Service] Environment="OLLAMA_HOST=0.0.0.0"' | sudo tee /etc/systemd/system/ollama.service.d/override.conf
sudo systemctl daemon-reload
sudo systemctl restart ollama
即可使得 Ollama 能够正常处理来自 Dify 的请求。
3.9 下载 Qwen-8B 并启动 vLLM 服务
若您已经下载好 Qwen-8B 模型,则跳过该步骤。
打开终端后,执行:
# 若 lfs 未下载,则执行以下命令下载 lfs
git lfs install
git clone https://www.modelscope.cn/Qwen/Qwen3-8B.git
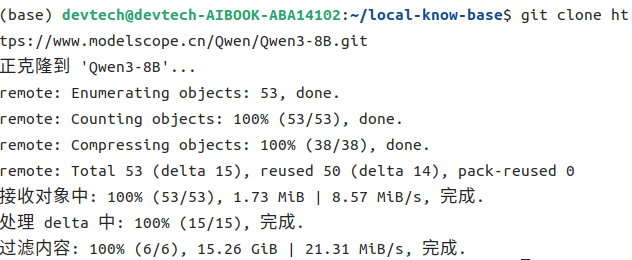
由于模型较大,需要一定等待时间。
模型下载完成后,我们在与模型存放文件夹内创建一个 vLLM 框架启动脚本。
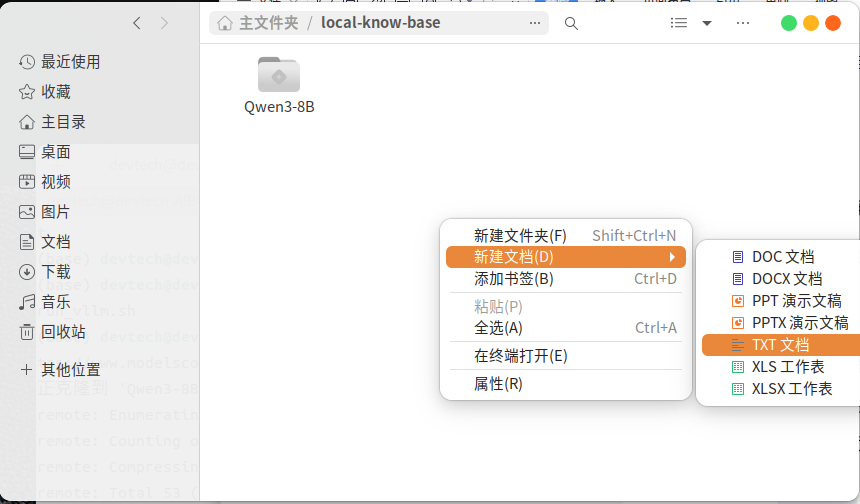
修改其文件名为:run_vllm.sh
脚本文件内容如下:
run_vllm.sh:
#!/bin/bash
python -m vLLM.entrypoints.openai.api_server \
--model ***/path/to***/Qwen3-8B \
--served-model-name qwen3-8b \
--host 0.0.0.0 \
--port 8000 \
--gpu-memory-utilization 0.9 \
--trust-remote-code
***/path/to*** 需要更改为 Qwen3-8B 模型实际存放路径,此处由于我们将 run_vllm.sh 脚本与 Qwen3-8B 模型存放在同一文件夹内,因此 ***/path/to*** 可以替换为 .。
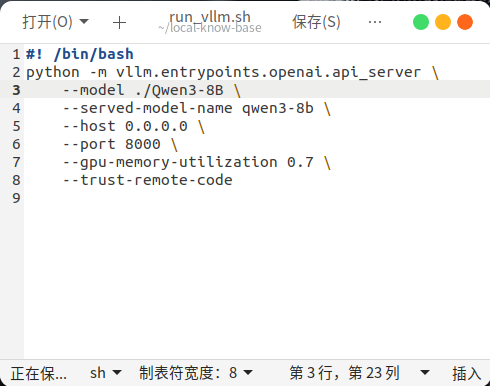
run_vllm.sh 脚本创建成功后,我们在脚本存放目录下单击右键,打开终端
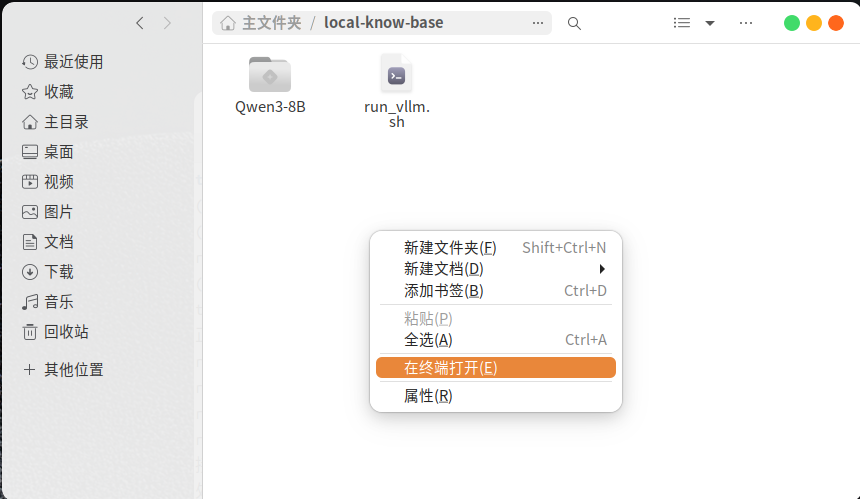
随后执行命令(请确保每次执行 run_vllm.sh 脚本时,都处于 localknowbase 的虚拟环境中):
conda activate localknowbase
bash run_vllm.sh
启动 vLLM 框架。
3.10 Dify 接入文本向量化模型
在 Dify 中配置文本向量化模型(Embedding Model)是实现 RAG(检索增强生成)功能的关键步骤。通过将文档内容转换为向量表示,系统能够进行语义搜索和相似度计算,从而实现基于知识库的精准问答。
Dify 支持通过 Ollama 接入本地部署的向量模型。由于我们在 3.4 节已经通过 Ollama 拉取了 nomic-embed-text 模型,现在只需在 Dify 中完成配置即可。
以下是 Dify 接入 Ollama 文本向量化模型的详细步骤:
首先,确保 Ollama 服务已正确配置为接受外部连接。在 3.8 节中,我们已经完成了 Ollama 服务的配置,使其能够监听 0.0.0.0 地址。您可以通过以下命令验证 Ollama 服务状态:
sudo systemctl status ollama
如果服务正常运行,您应该看到 active (running) 状态。
接下来,在 Dify 中配置 Embedding 模型:
- 登录 Dify 后,点击右上角个人头像,选择 "设置" 进入设置页面
- 在左侧菜单中选择 "模型供应商",进入模型配置页面
- 在搜索框中输入 "ollama",找到 Ollama 插件并点击安装。如果之前配置 LLM 时已经安装过 Ollama 插件,则可以跳过此步骤
- 安装完成后,点击 "添加模型" 按钮,在弹出的对话框中进行如下配置:
- 模型类型:选择
Text Embedding(文本嵌入) - 模型名称:输入
nomic-embed-text - 基础 URL:输入
http://172.17.0.1:11434
- 模型类型:选择
- 点击 "保存" 完成配置
配置参数说明:
- 模型类型:Text Embedding 表示这是一个文本向量化模型,用于将文本转换为向量表示
- 模型名称:nomic-embed-text 是 Ollama 提供的高性能向量模型,支持多语言文本嵌入
- 基础 URL:172.17.0.1 是 Docker 默认的网关地址,Dify 容器通过此地址访问宿主机上的 Ollama 服务。11434 是 Ollama 的默认端口
验证配置是否成功:
配置完成后,您可以在模型供应商页面看到已添加的 nomic-embed-text 模型。模型名称旁会显示 Text Embedding 标签,表示这是一个文本向量化模型。
此时,您已经成功完成了 Dify 接入本地文本向量化模型的配置。接下来,在创建知识库时,Dify 将自动使用此模型对上传的文档进行向量化处理,为后续的语义检索和问答提供基础支持。
技术原理说明:
文本向量化(Text Embedding)是将文本转换为高维数值向量的过程。nomic-embed-text 模型基于 Transformer 架构,能够将输入文本编码为固定长度的稠密向量。这些向量捕获了文本的语义信息,使得语义相似的文本在向量空间中距离较近。
在 RAG 流程中,当用户上传文档时:
- 文档被切分为适当大小的文本块
- 每个文本块通过 Embedding 模型转换为向量
- 向量被存储到向量数据库(Weaviate)中
- 用户提问时,问题也被转换为向量
- 系统在向量数据库中检索最相似的文本块
- 检索结果作为上下文提供给 LLM 生成回答
这种架构确保了知识库问答的准确性和相关性,同时所有数据处理都在本地完成,充分保护用户隐私。
4. 最佳实践
经过之前的努力,您已经成功在 MTT AIBOOK 上部署了 Dify,并为我们基于 Dify 搭建本地个人知识库做好的充分准备。此时我们可以发挥 MTT AIBOOK 本地算力的强大能力,基于 Dify 与本地模型搭建个人本地知识库。由于模型均运行于本机,因此能够最大程度保证隐私,所有数据不上云。
4.1 访问 Dify 主页面
打开浏览器,输入 http://localhost,即进入 Dify 主页面。
4.2 使 Dify 接入本地模型
4.2.1 使 Dify 接入本地大语言模型(LLM)
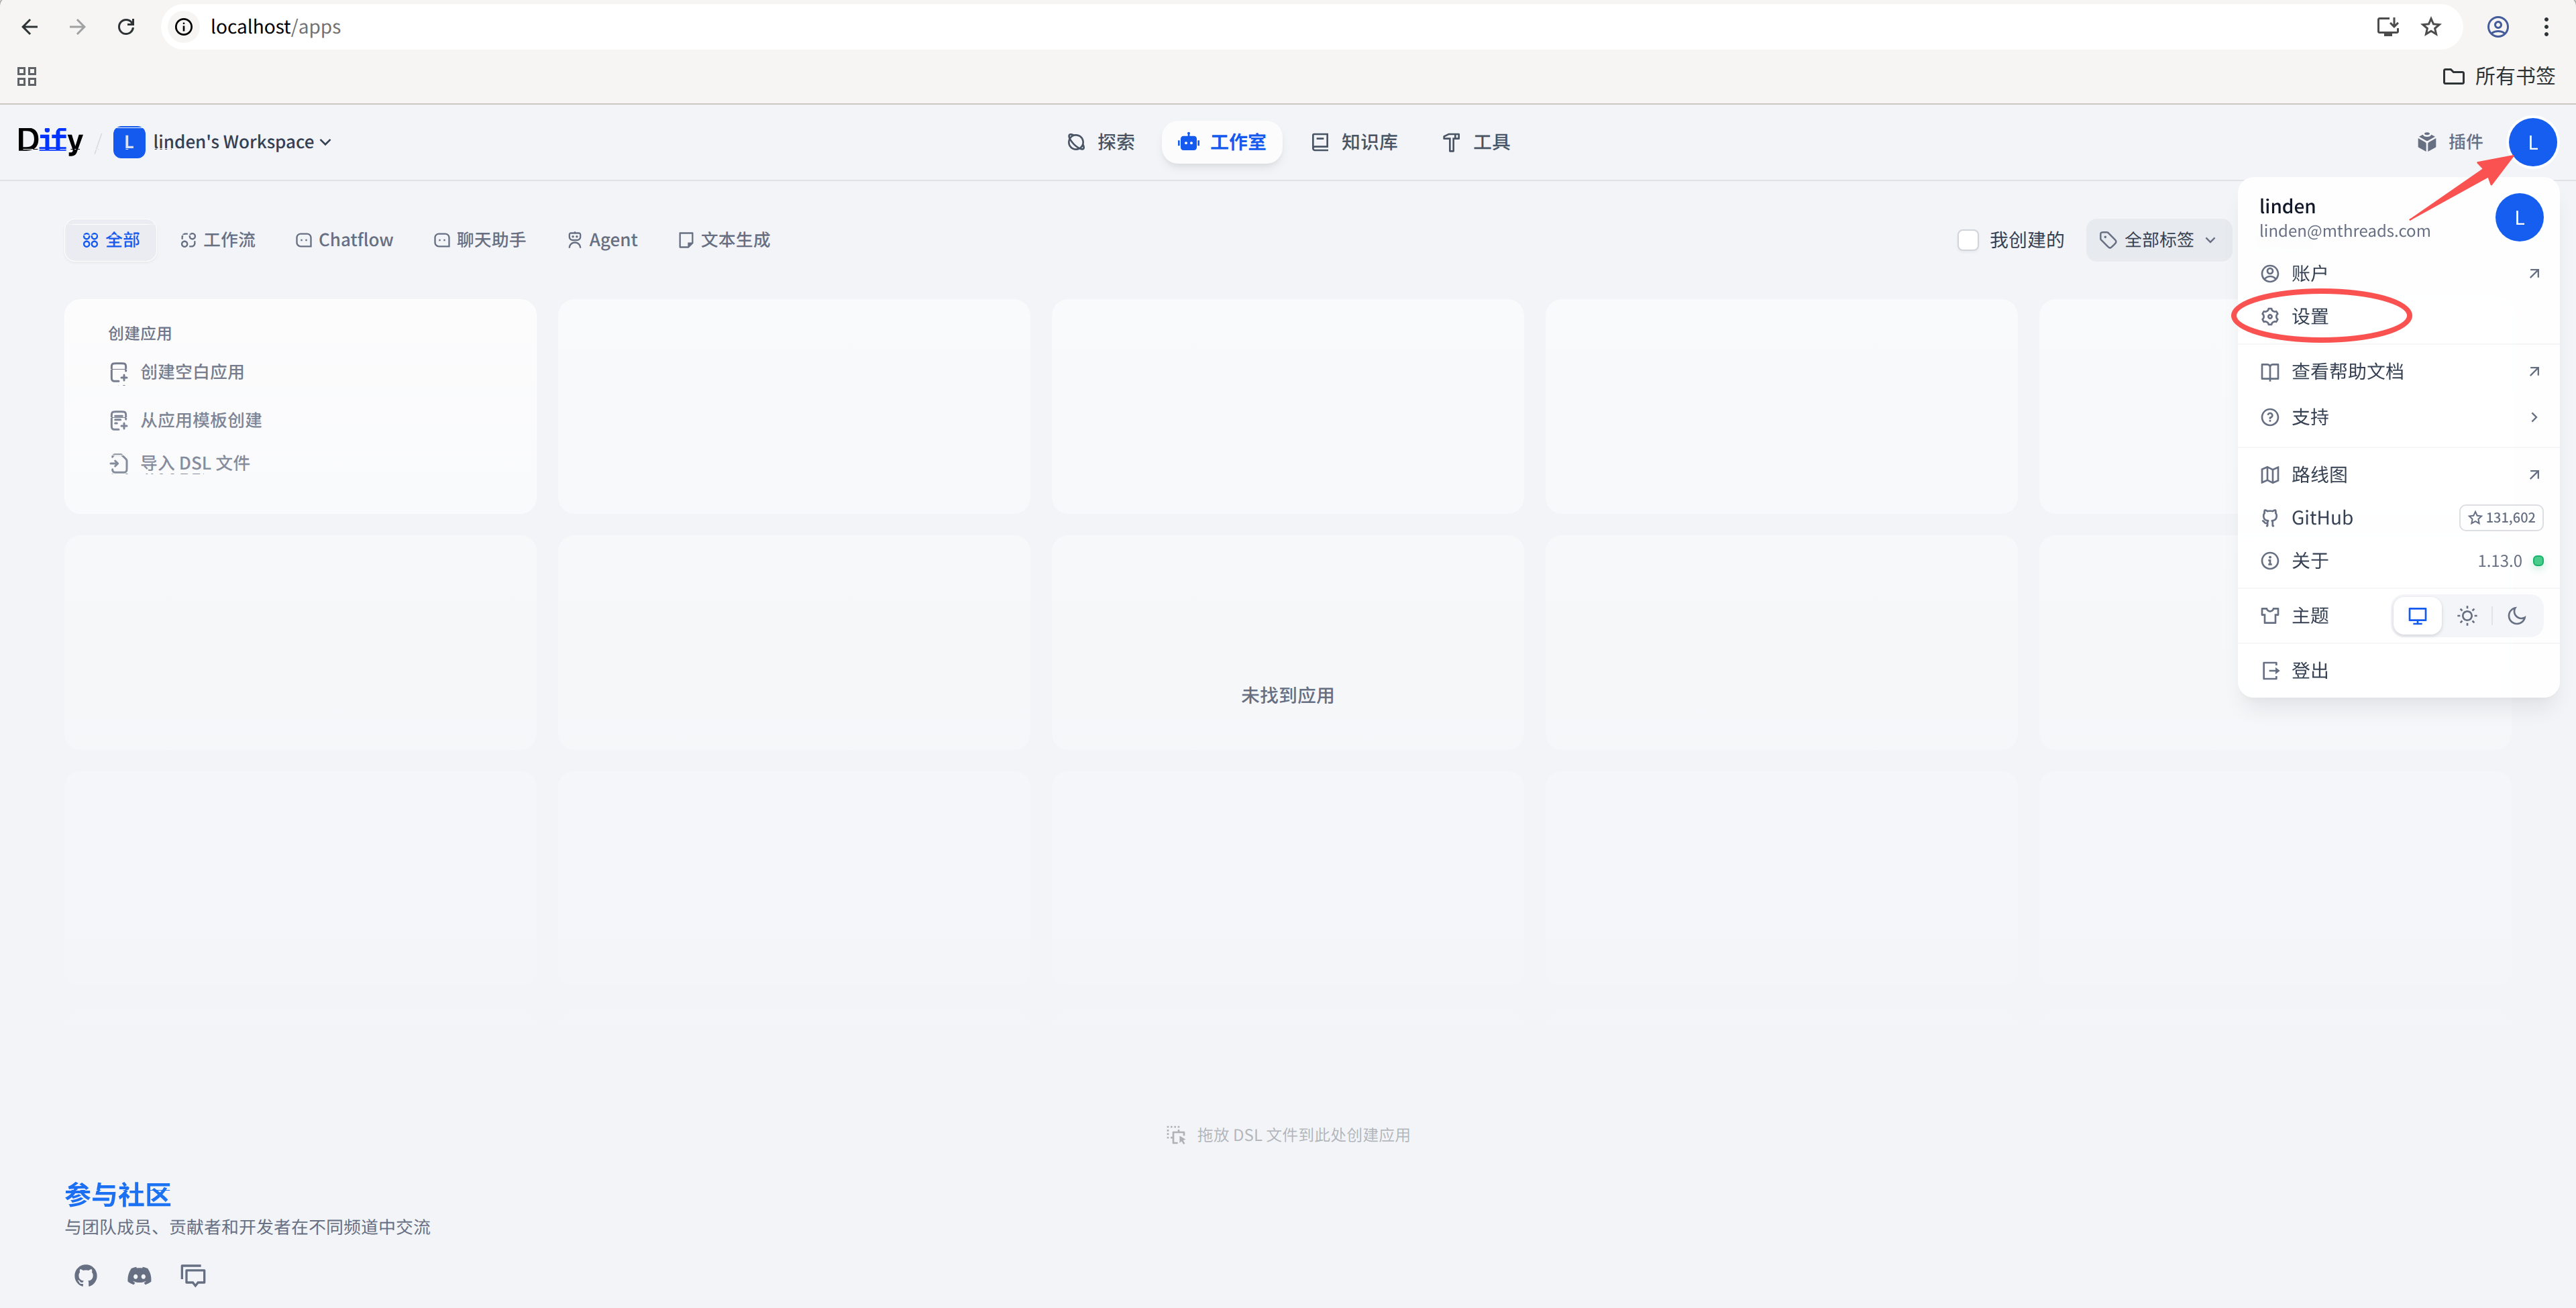
首次进入主界面时,需要先点击右上角的个人头像,展开菜单后,点击 "设置"。
进入设置界面后,点击 "模型供应商",即可进入模型配置页面。
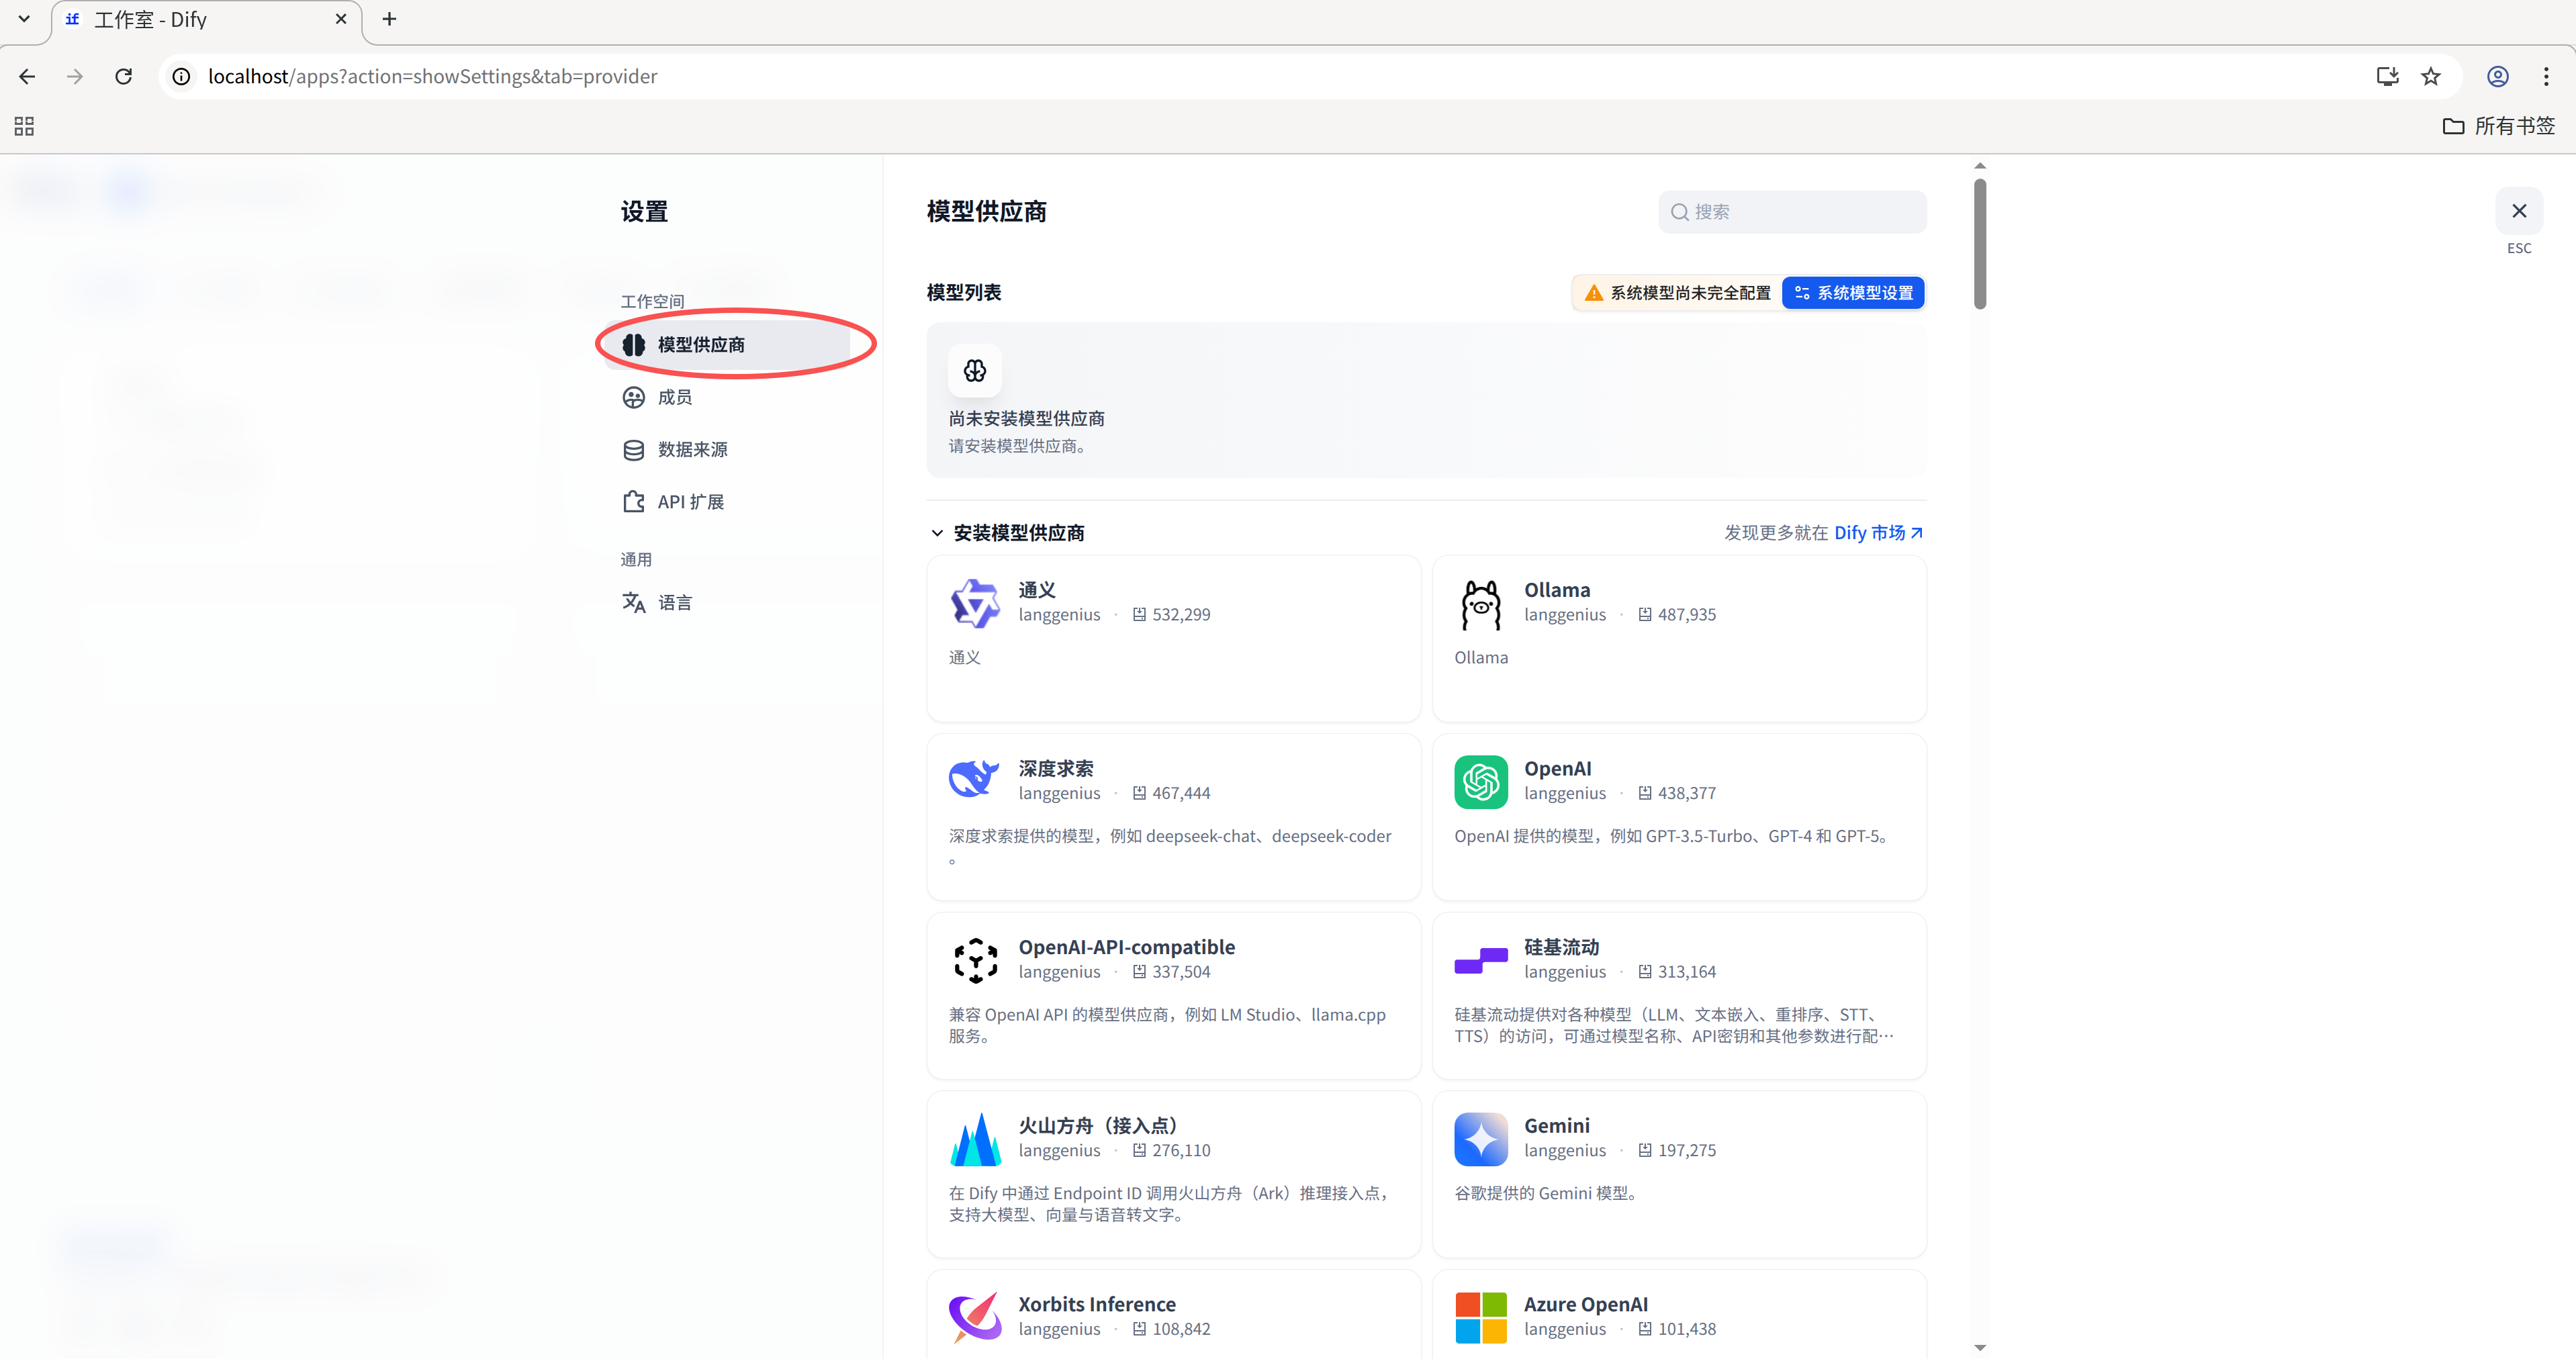
随后点击搜索框,输入 vllm,点击安装。
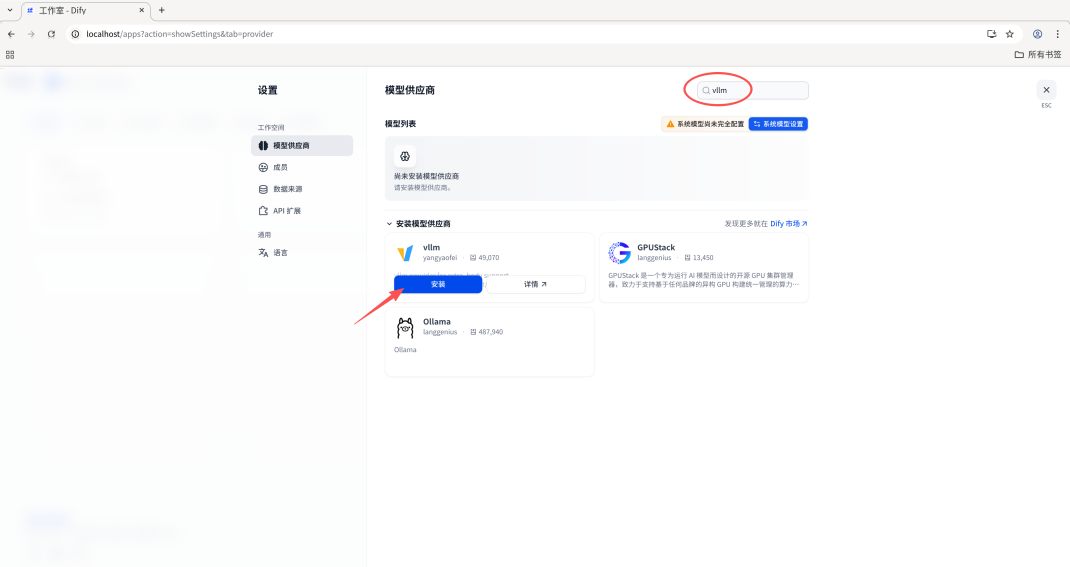
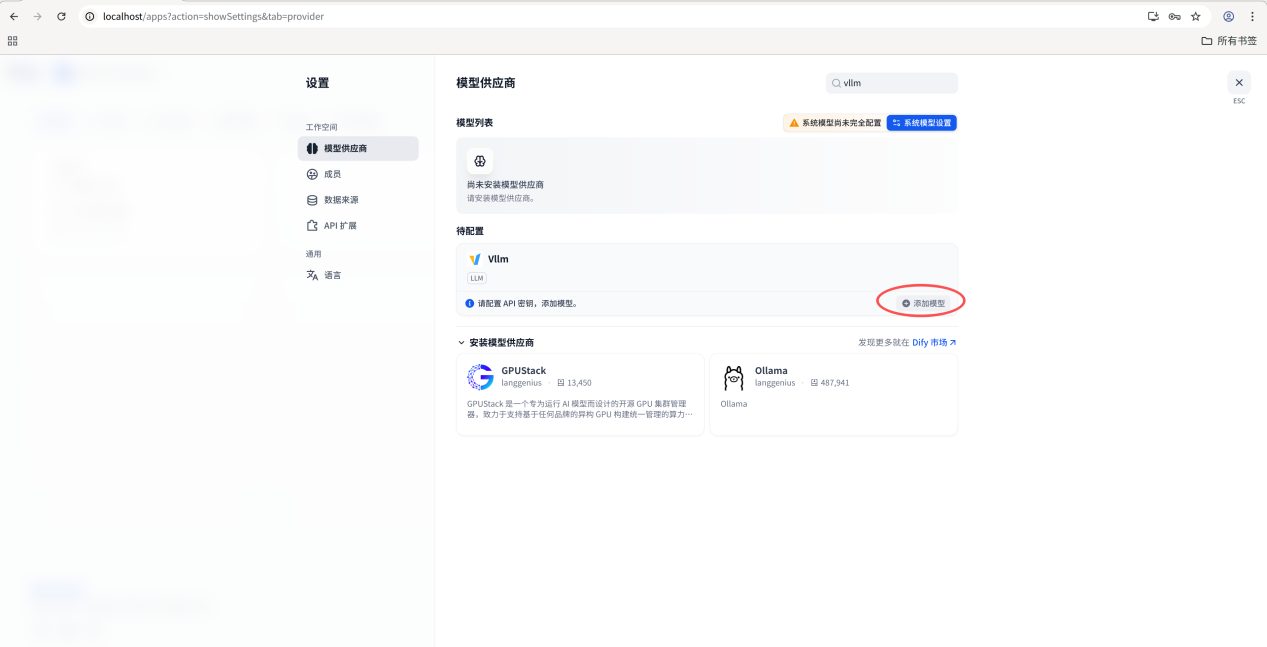
vLLM 安装成功后,单击 "添加模型",即可将刚刚您启动的 vLLM 服务添加入 Dify 的模型供应商中。
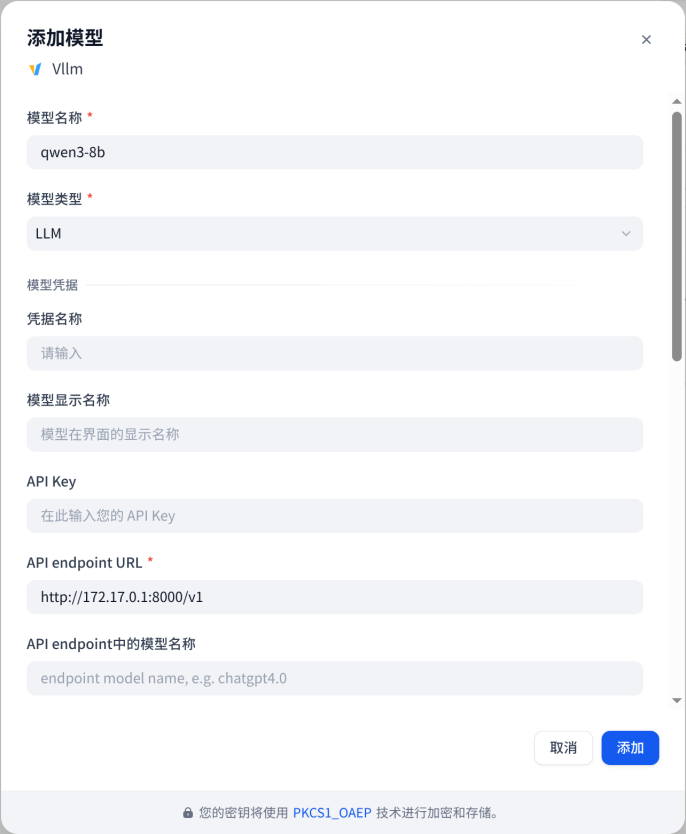
根据下图输入对应信息:
| 项目 | 值 | 说明 |
|---|---|---|
| 模型名称 | qwen3-8b | 与 run_vllm.sh 脚本中的 served-model-name 参数保持一致,不要有空格或大小写错误 |
| API endpoint URL | http://172.17.0.1:8000/v1 | Dify 容器通过 Docker 的虚拟网关 (172.17.0.1),找到宿主机上 8000 端口的程序,并按照 OpenAI 标准的 /v1 格式与它进行对话 |
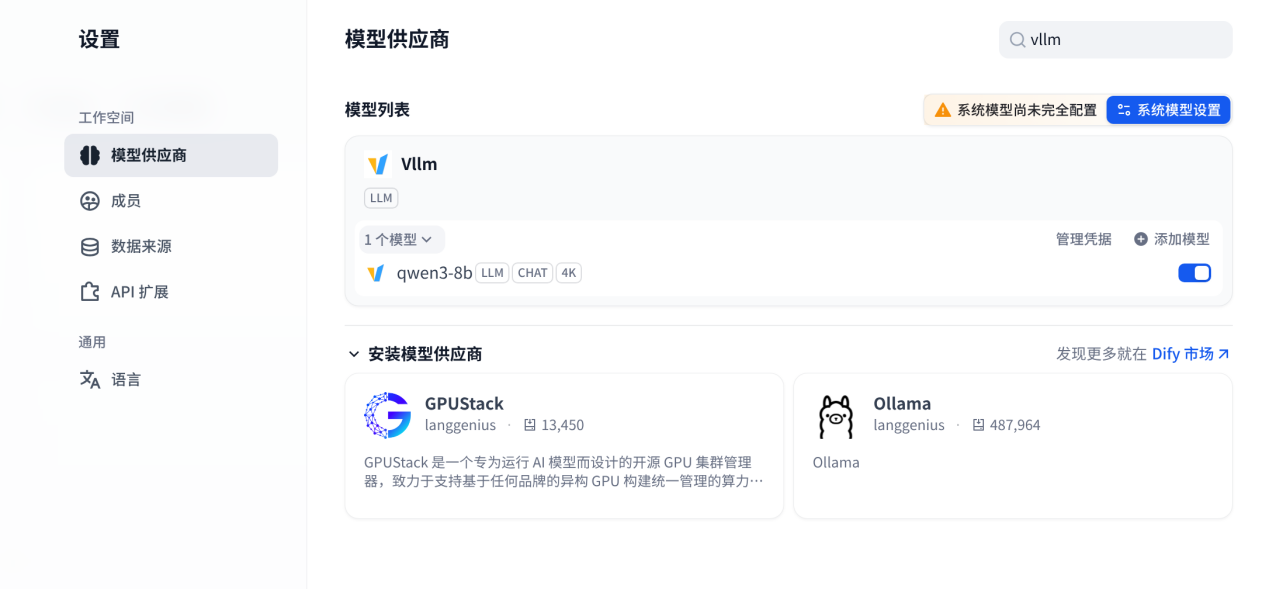
成功配置后,即可在模型配置页面显示我们已经配置的 qwen3-8b 模型。
4.2.2 使 Dify 接入本地文本向量化模型(Embedding)
首次进入主界面时,需要先点击右上角的个人头像,展开菜单后,点击 "设置"。
进入设置界面后,点击 "模型供应商",即可进入模型配置页面。
随后点击搜索框,输入 ollama,点击安装。
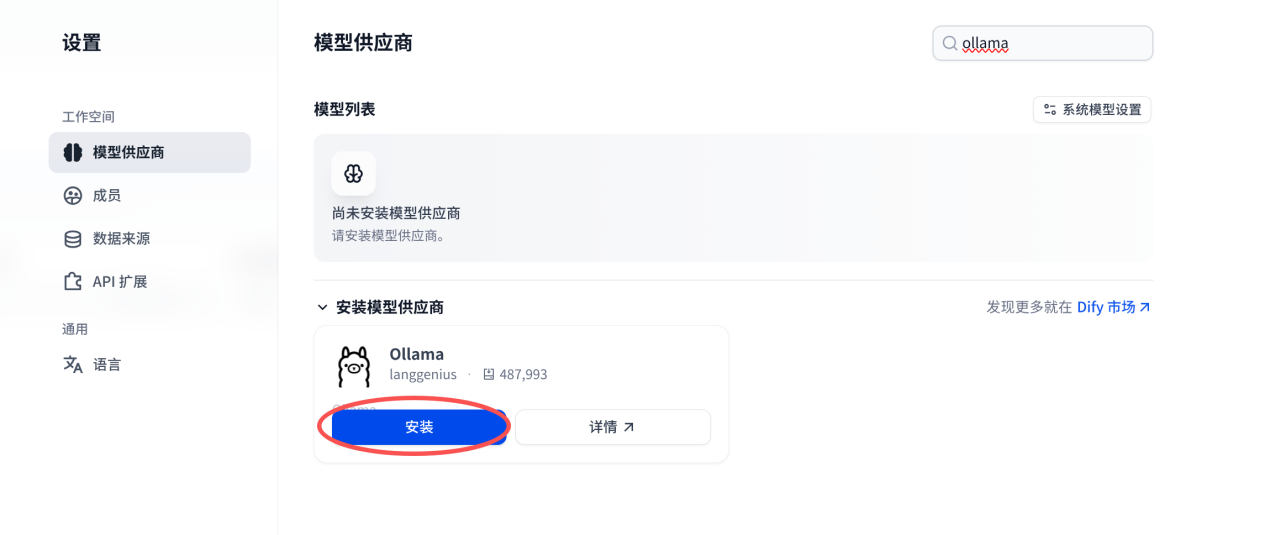
Ollama 插件安装成功后,单击 "添加模型",即可将在后台运行的本地 Ollama 服务添加入 Dify 的模型供应商中。
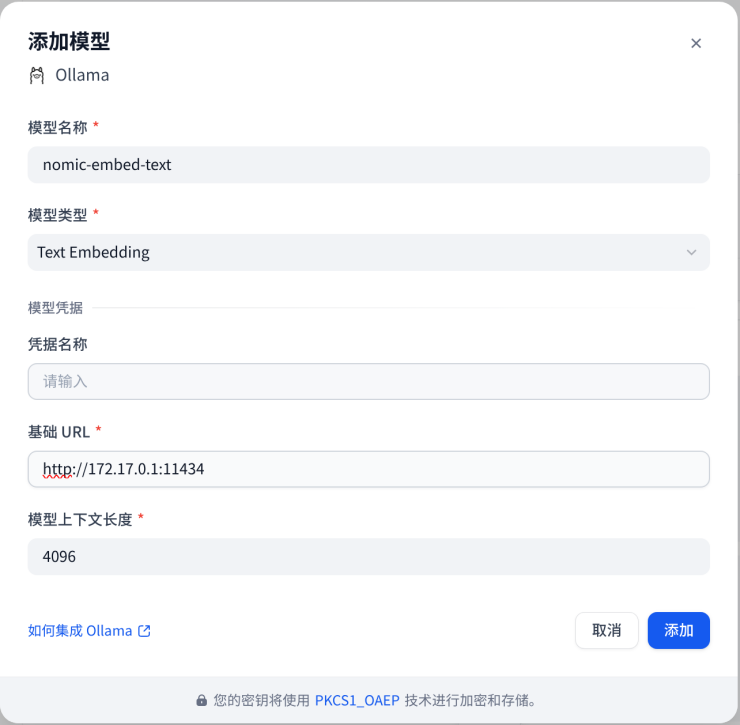
| 项目 | 值 | 说明 |
|---|---|---|
| 模型名称 | nomic-embed-text | 不要有空格或大小写错误 |
| API endpoint URL | http://172.17.0.1:11434 | 注意对 Ollama 设置的端口号是否为 11434,默认为该值 |
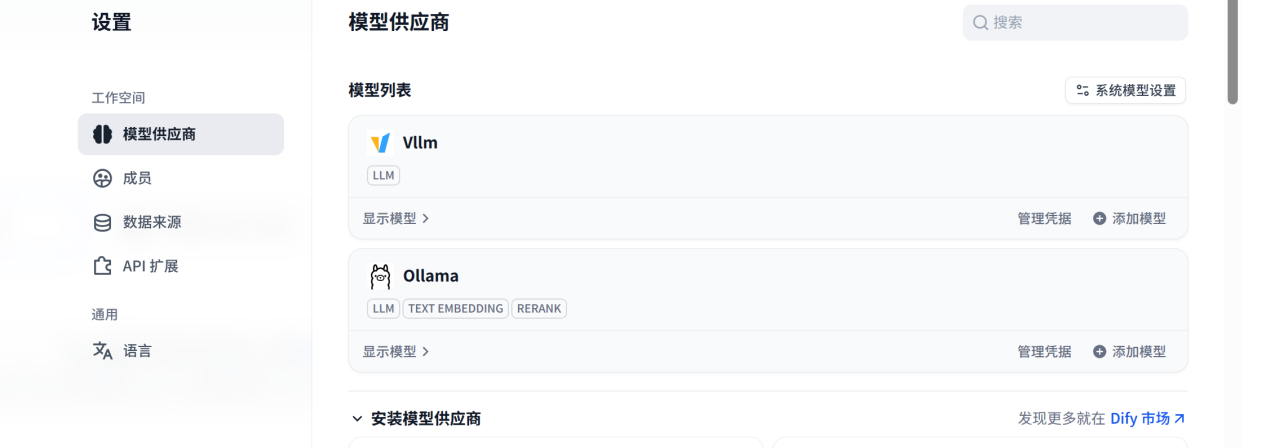
成功配置后,即可在模型配置页面显示我们已经配置的 nomic-embed-text 模型。
4.3 创建知识库
-
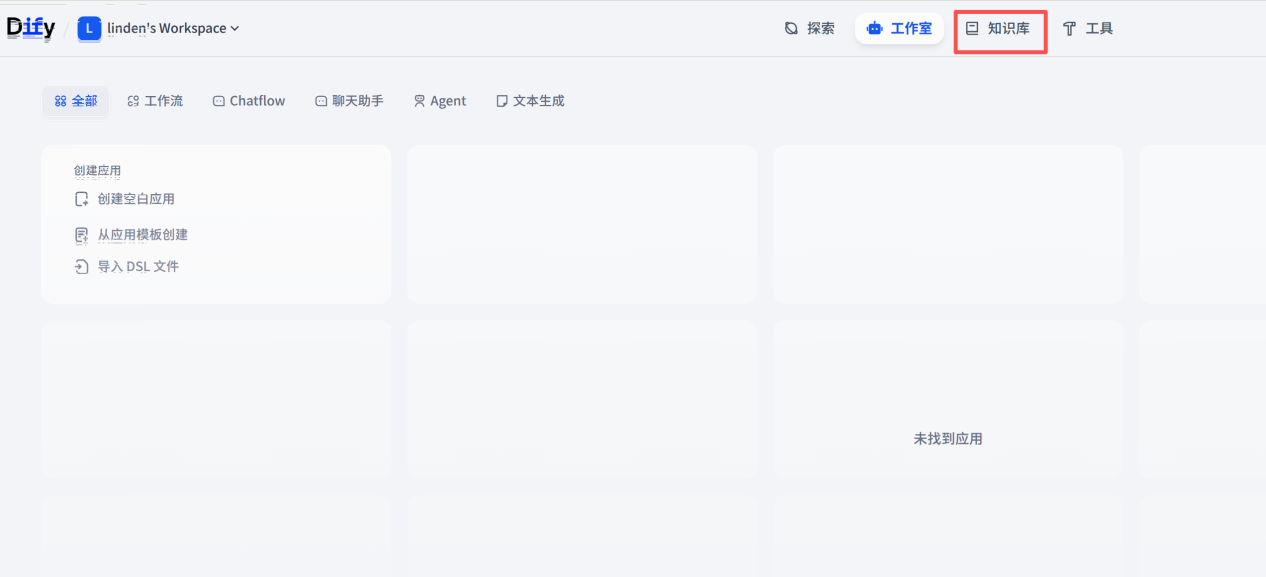
在 Dify 主界面,点击上方的 "知识库",点击 "创建知识库"
-
导入已有文本,上传资料,点击 "下一步"
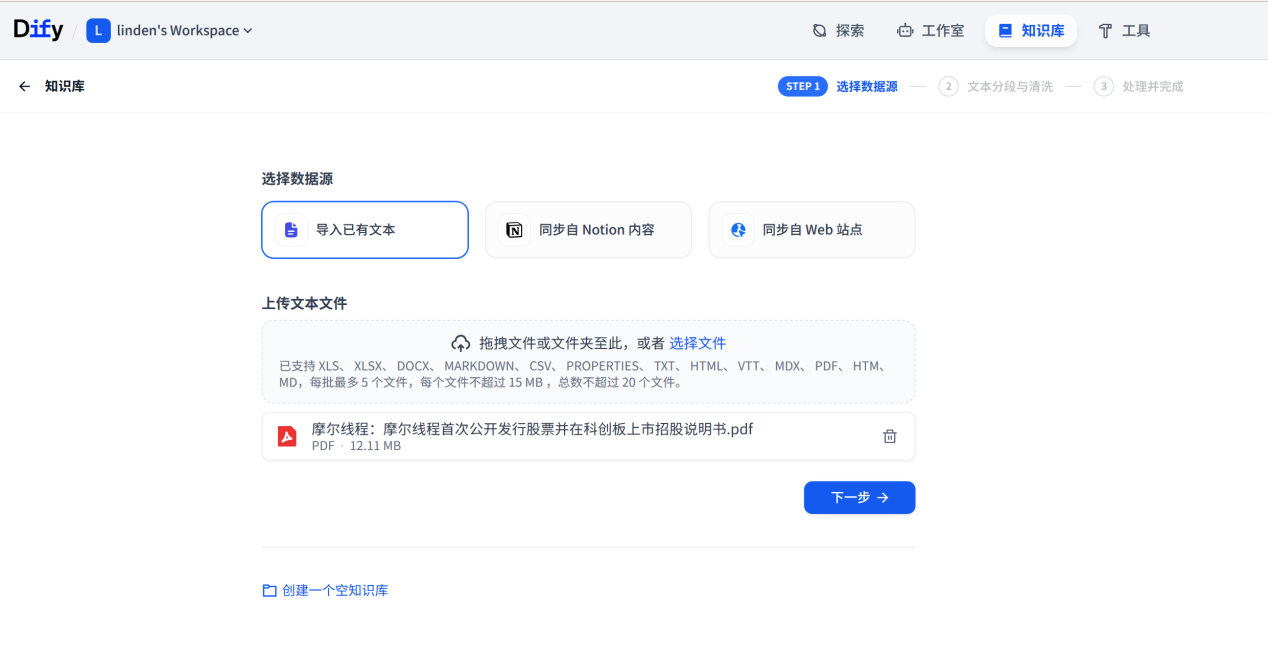
-
随后,配置索引方式(推荐高质量)、检索设置参数后,点击 "保存并处理"
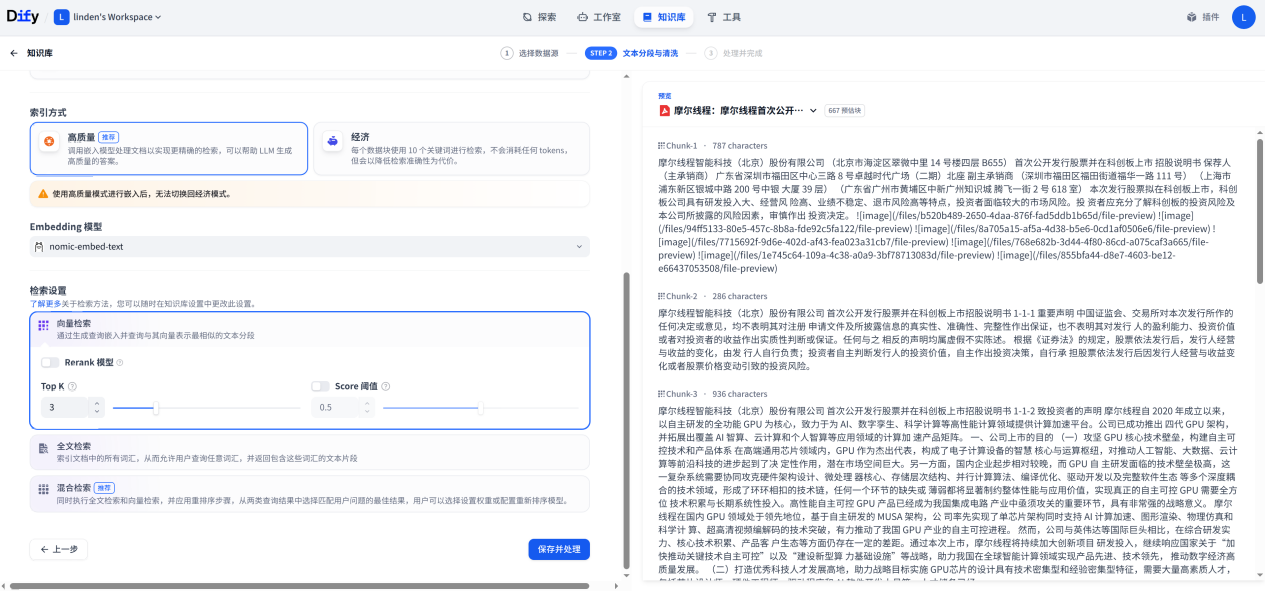
-
知识库创建完毕,等待向量化模型针对传入的文件进行文本向量化处理
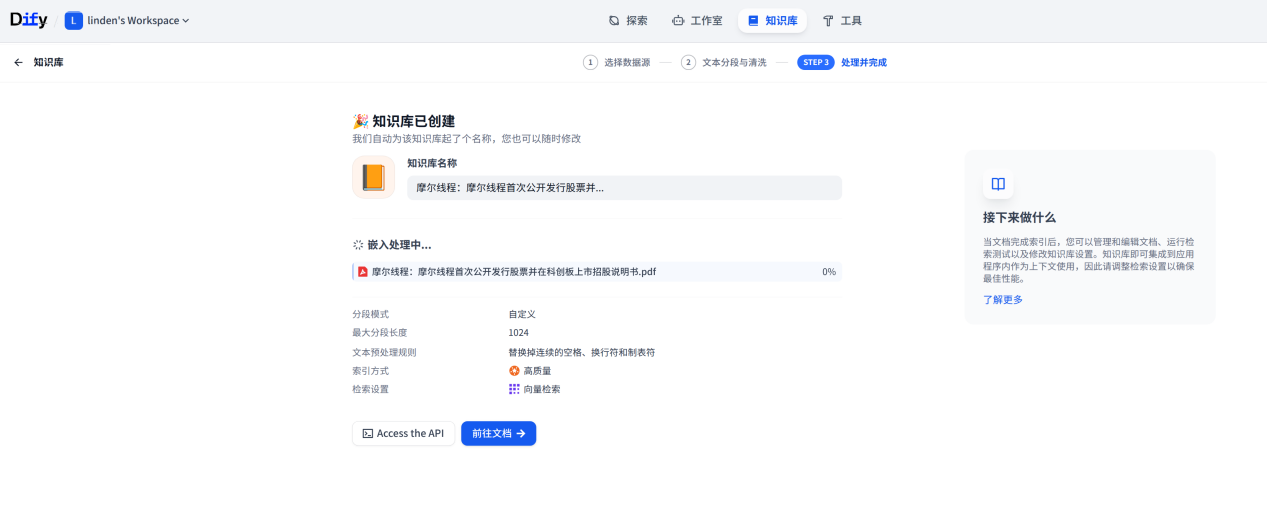
-
等待向量化处理完成后,我们可以正常使用该知识库
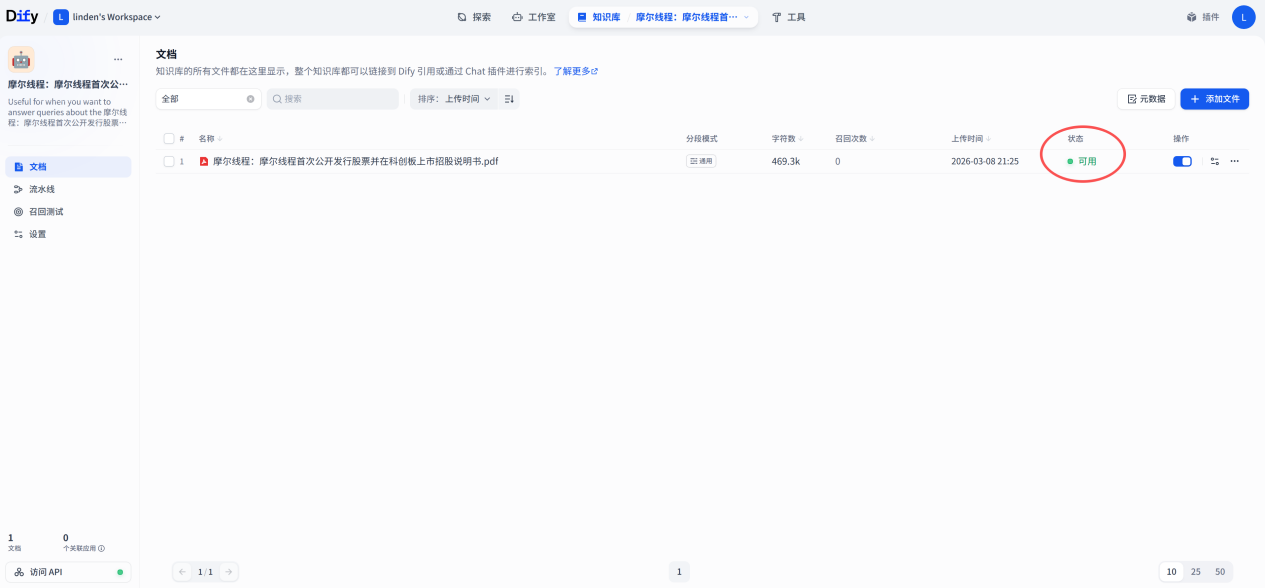
4.4 创建个人知识库应用
-
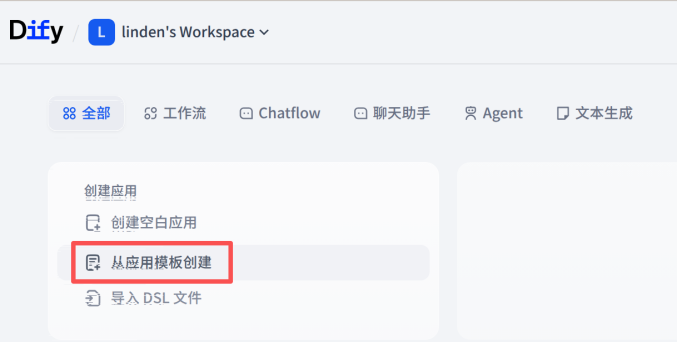
点击主页面的 "从应用模板创建",进入模板应用创建流程
-
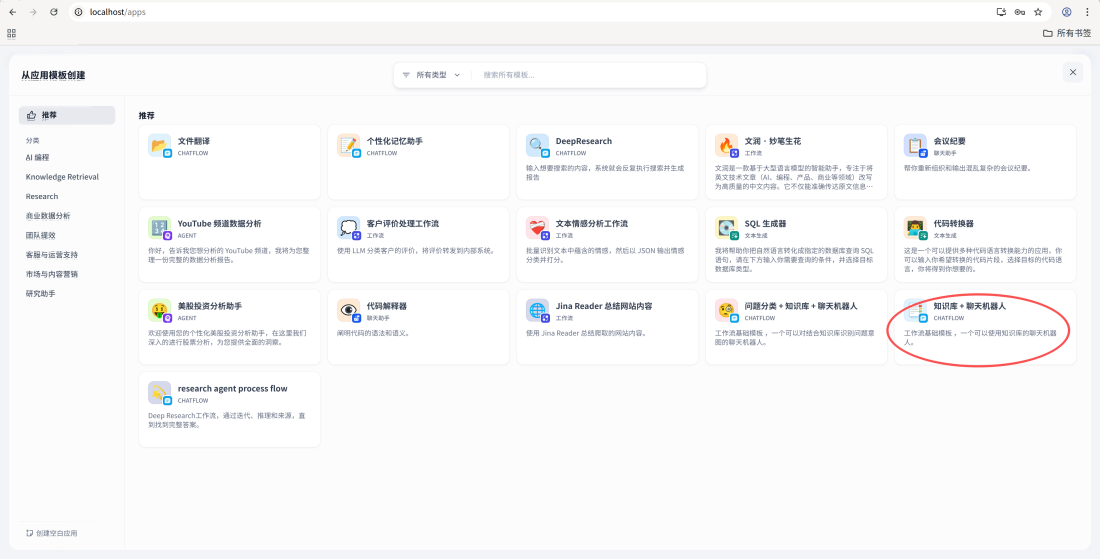
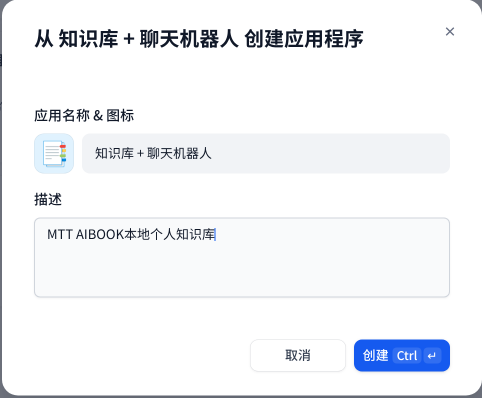
点击 "知识库 + 聊天机器人",即可创建本地个人知识库应用
-
创建成功后,将自动进入应用工作流编排页面,选中 LLM 节点与参数提取器节点,将这两个节点的默认选中模型分别由
gpt3.5-turbo与gpt-4o更换为本地模型qwen3-8b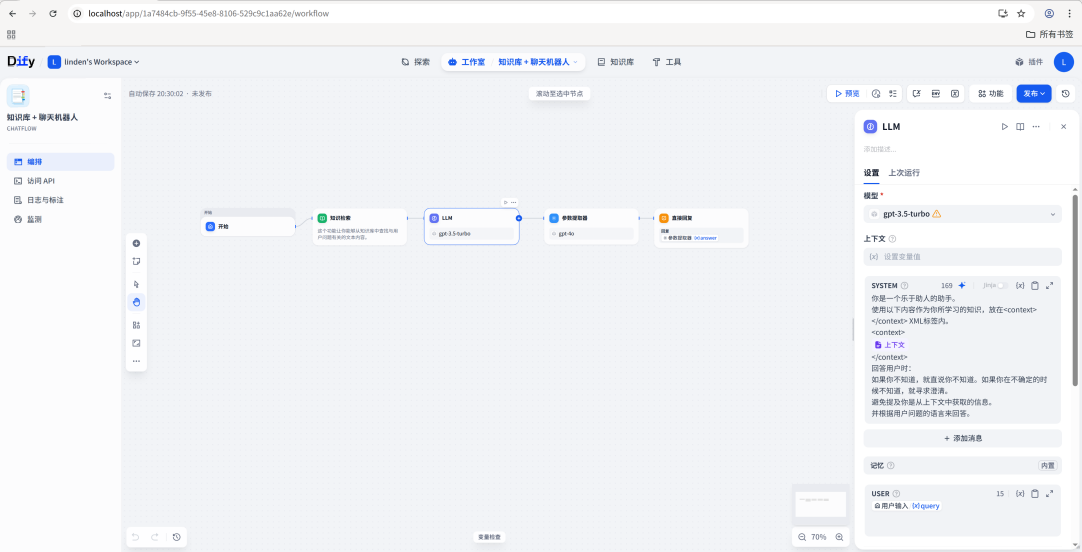
-
点击模型后,选中我们配置好的
qwen3-8b模型,即可完成这两个节点由默认的云端模型切换为本地模型qwen3-8b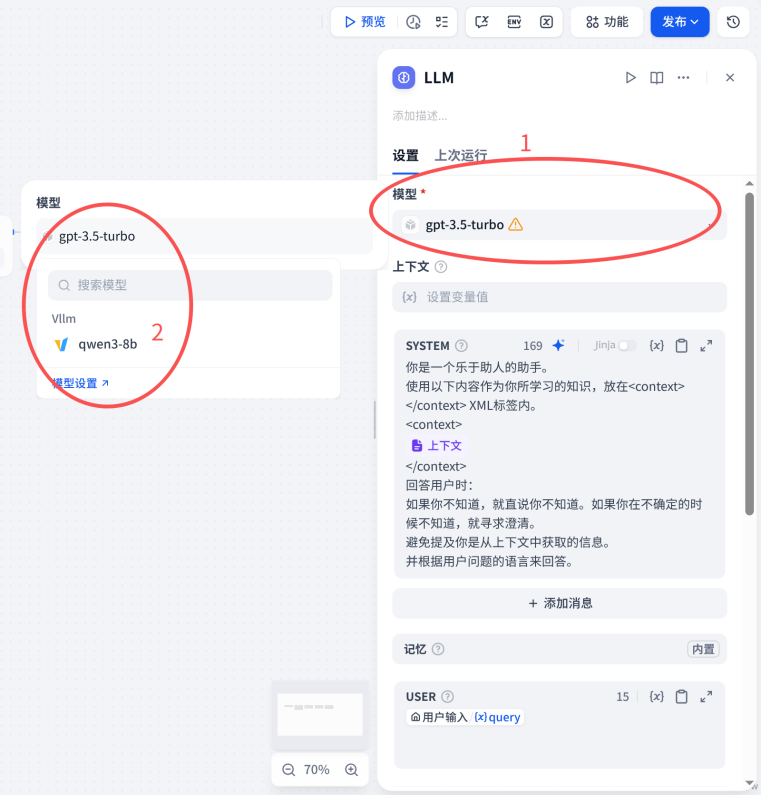
-
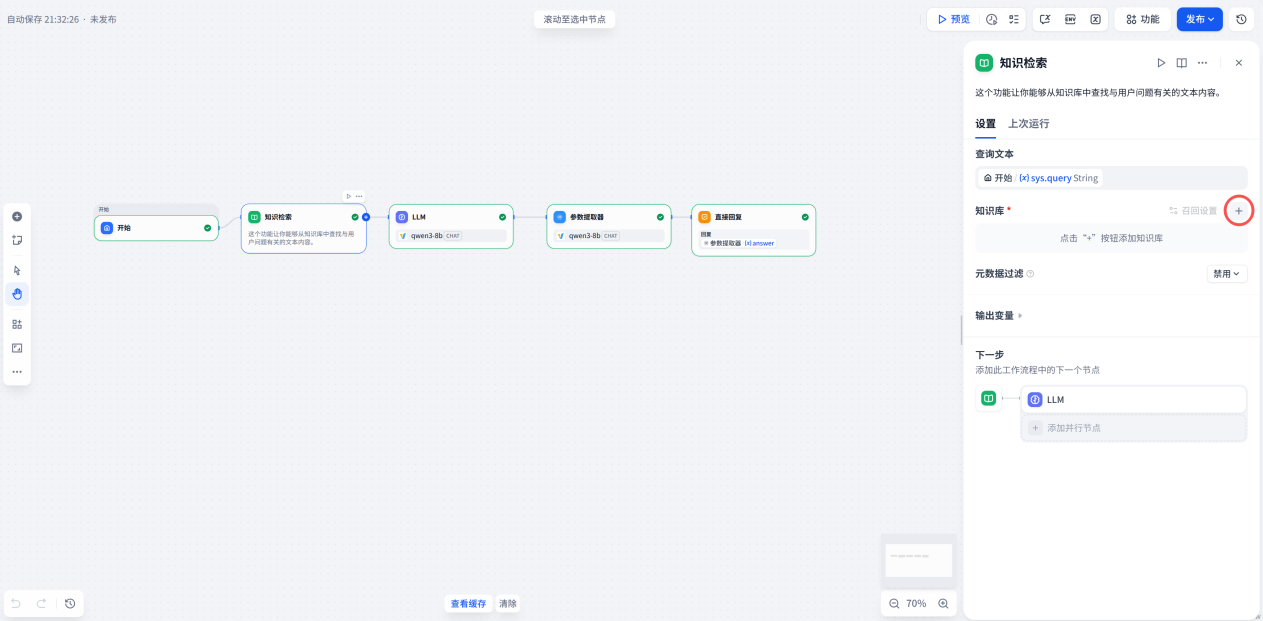
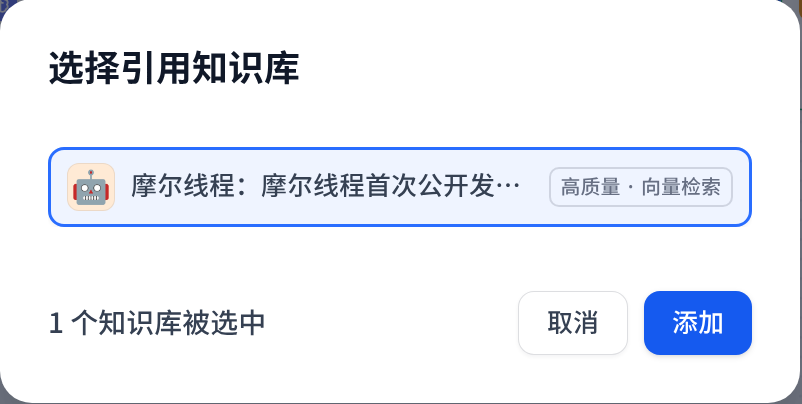
点击知识检索节点,随后点击 "+" 添加知识库
4.5 使用个人知识库应用
点击 "预览",即可在右侧聊天框输入你的问题。
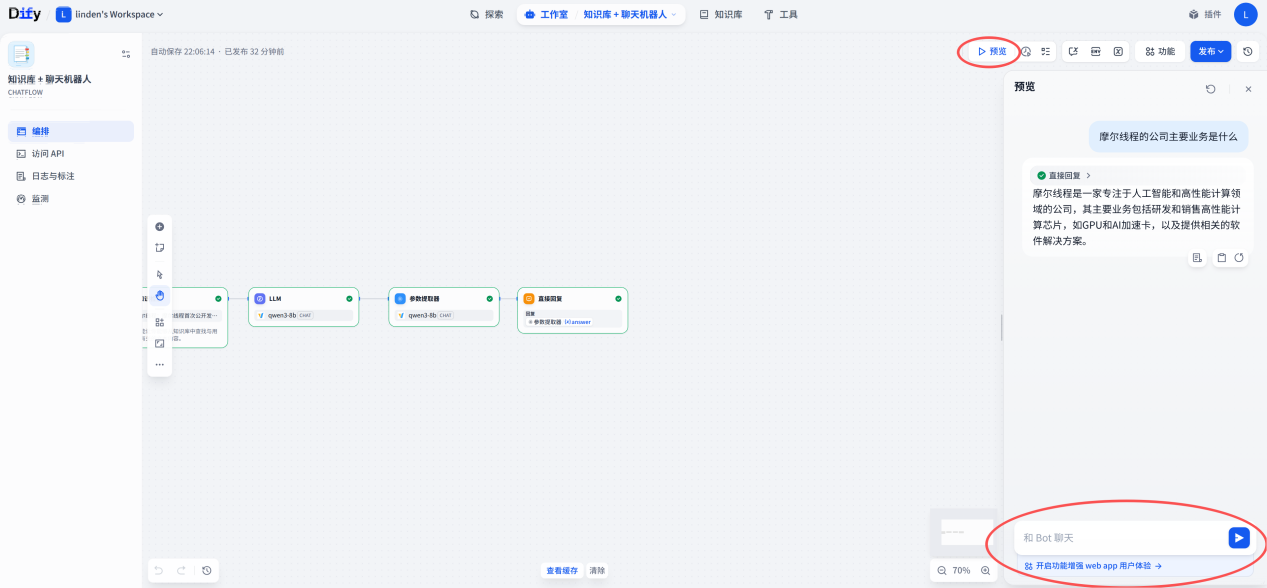
当用户在聊天框输入问题时,系统会瞬间启动以下流程:
- 查询向量化 (Query Embedding):系统首先截获用户的提问,并将其发送给同一个 Embedding 模型,把这句简短的提问也转化为一个高维向量
- 相似度检索 (Vector Search):系统拿着这个代表"问题"的向量,去向量数据库(Weaviate)的高维空间中进行近似最近邻搜索(ANN)。通过计算余弦相似度(Cosine Similarity),数据库会光速返回与问题语义最接近的几个文本块(即 Top-K 召回)
- 上下文组装 (Prompt Assembling):检索到相关文本块后,Dify 会在后台将这些文本块与用户原本的问题拼接在一起,构建成一个结构化的提示词(Prompt)。类似于拼成这样:"请根据以下参考资料回答问题。资料:[召回的文本块 1]、[召回的文本块 2]。问题:[摩尔线程发布的产品是什么?]"
- 大模型生成 (LLM Generation):最后,这个包含了丰富背景知识的"超级提示词"会被发送给您的主语言模型(例如本地部署的
qwen3-8b)。模型根据被"增强"的上下文,生成最终的专业、准确且附带引用来源的回答
5. 附录
5.1 常见问题
| 问题描述 | 可能原因 | 解决方案 |
|---|---|---|
| docker-compose 安装失败 | 网络问题或下载链接错误 | 1. 检查网络连接 2. 确认下载链接是否正确 3. 尝试使用其他版本的 docker-compose |
| 向量模型拉取失败 | 网络问题或模型不存在 | 1. 检查网络连接 2. 确认模型名称是否正确 3. 尝试使用其他向量模型 |
| docker-compose.yml 文件配置错误 | 语法错误或参数配置不当 | 1. 检查 docker-compose.yml 文件的语法是否正确(尤其注意缩进,与 python 类似,需要使用空格进行缩进) 2. 确认参数配置是否符合要求 3. 参考官方文档进行配置 |
| Ollama 服务无法连接 | Ollama 未启动或配置不正确,未监听 0.0.0.0 地址 | 1. 检查 Ollama 服务状态:sudo systemctl status ollama2. 确认已按照 3.8 节配置 OLLAMA_HOST 环境变量3. 重启 Ollama 服务: sudo systemctl restart ollama |
| vLLM 启动失败或报错 | 模型路径错误、GPU 内存不足或 conda 环境未激活 | 1. 检查模型路径是否正确 2. 降低 gpu-memory-utilization 参数值(如改为 0.7)3. 确认已激活 localknowbase 环境: conda activate localknowbase |
| Dify 无法访问本地模型 | Docker 容器无法访问宿主机服务,或端口配置错误 | 1. 确认使用 172.17.0.1 作为宿主机地址 2. 检查 Ollama 和 vLLM 服务端口是否正确 3. 检查防火墙设置是否允许容器访问宿主机 |
| 知识库文档处理失败 | 文档格式不支持、文件过大或 Embedding 模型配置错误 | 1. 确认文档格式为 PDF、TXT、DOCX 等支持的格式 2. 尝试减小文件大小或分批上传 3. 检查 Embedding 模型配置是否正确 |
| 知识库问答效果不佳 | 检索参数设置不当、文档切分策略不合适或模型能力不足 | 1. 调整检索设置中的 Top-K 值和相似度阈值 2. 尝试不同的索引方式(高质量/经济) 3. 考虑使用更大的语言模型提升理解能力 |
| Dify 页面加载缓慢或卡顿 | 系统资源不足,特别是内存或 CPU 占用过高 | 1. 关闭不必要的应用程序释放资源 2. 检查 Docker 容器资源使用情况: docker stats3. 考虑重启 Dify 服务: docker-compose restart |
5.2 相关资源
- Dify 官方文档:https://docs.dify.ai/(了解 Dify 更多功能和使用方法,包括工作流编排、Agent 开发等高级特性)
- Dify GitHub 仓库:https://github.com/langgenius/dify(获取最新版本、提交 Issue、参与社区讨论)
- Ollama 官方文档:https://github.com/ollama/ollama(了解 Ollama 支持的模型列表和高级配置选项)
- vLLM 官方文档:https://docs.vllm.ai/(了解 vLLM 的性能优化选项和部署最佳实践)
- 摩尔线程开发者文档:https://developer.mthreads.com/(获取 MTT AIBOOK 相关开发资源和技术支持)
- Qwen 模型官方文档:https://github.com/QwenLM/Qwen(了解 Qwen 系列模型的使用方法和微调技巧)