【高级】模型训练实战:在 AutoDL平台使用摩尔线程 GPU 完成 CIFAR-10 图像分类
更新日志
| 版本 | 日期 | 变更描述 |
|---|---|---|
| 1.0.0 | 2026-01-30 | 初始版本,包含在 AutoDL 平台使用摩尔线程 S4000 完成 CIFAR-10 图像分类的完整训练指南。 |
1. 项目简介
本教程旨在指导开发者在 AutoDL 算力平台上,使用摩尔线程 GPU 完整训练一个经典的 CIFAR-10 图像分类模型,体验从数据加载、模型设计、训练优化到性能评估的完整 AI 开发流程。
难度:高级,适合有开发经验的开发者体验
CIFAR-10 数据集简介: CIFAR-10 是计算机视觉领域的经典数据集,包含飞机、汽车、鸟类、猫、鹿、狗、青蛙、马、船、卡车等 10 个类别的 32×32 像素彩色图像。数据集包含 50,000 个训练图像和 10,000 个测试图像。
2. 前置条件
在开始本教程之前,请确保您已满足以下所有条件:
- 硬件: 本地开发环境(建议选用 AI 算力本 MTT AIBOOK,型号 A141,可用于本地运行和调试。MTT AIBOOK 本地和云端都基于 MUSA,将代码保存在本地能即刻跑通。)
- 软件:
- 已注册 AutoDL 平台账户。
- 具备 Python 编程基础(熟悉基本语法和面向对象编程)。
- 了解深度学习基本概念(如神经网络、损失函数、优化器等)。
- 熟悉命令行操作(Linux 终端或 Windows PowerShell)。
- 了解 PyTorch 框架基本用法(可选,教程中会详细说明)。
3. 环境部署
本章节描述如何在 AutoDL 平台上配置环境并部署项目。
3.1 登录 AutoDL 平台
-
访问 AutoDL 官网并创建账户。
访问 AutoDL 官网,完成账户注册和实名认证流程。
-
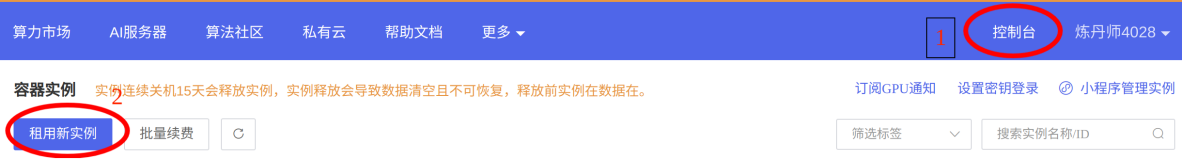
进入控制台并选择租用新实例。
-
登录后进入控制台界面。
-
点击 "租用新实例" 按钮。
-
3.2 配置新实例
-
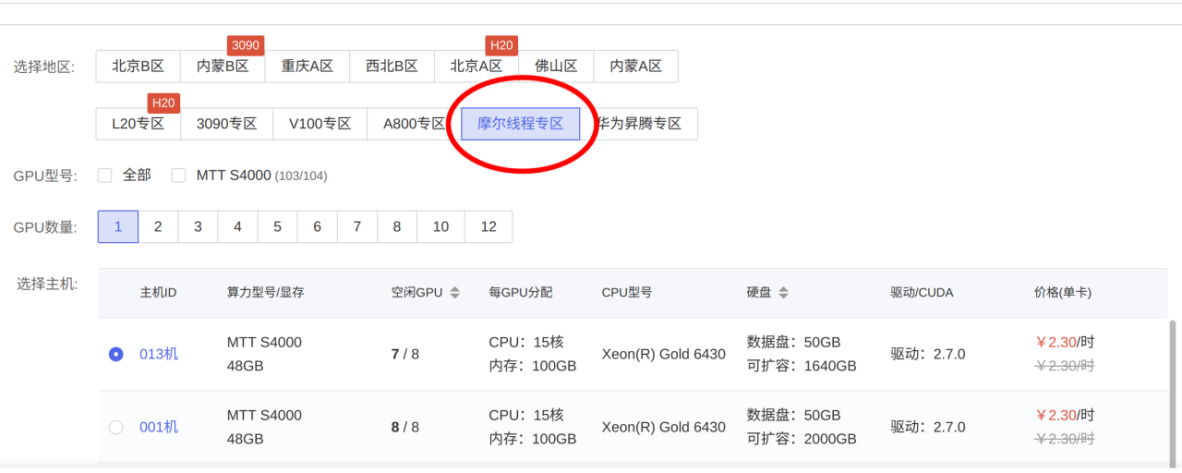
选择摩尔线程专区。
在实例配置页面,选择 "摩尔线程专区" 以使用摩尔线程 GPU。
-
选择社区镜像。
- 在镜像选择中,选择 "社区镜像" 搜索关键词 cifar10。
- 选择包含 CIFAR-10 训练环境的镜像(通常显示为包含 PyTorch 和 MUSA 支持的镜像)。
-
配置实例规格。
根据项目需求选择合适的 GPU 型号和实例配置(建议至少 8GB 显存)。
-
启动实例。
点击 "立即创建" 完成实例创建,等待实例启动完成。
3.3 进入终端控制实例
-
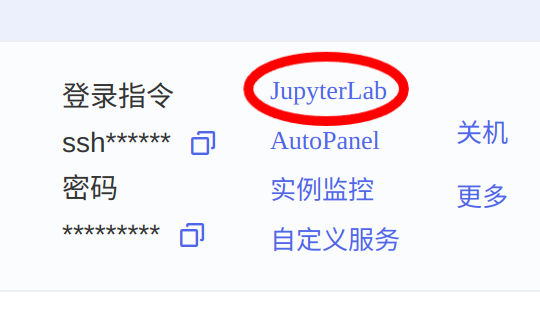
打开 JupyterLab。
实例启动后,点击 "JupyterLab" 按钮,进入 JupyterLab 界面。
-
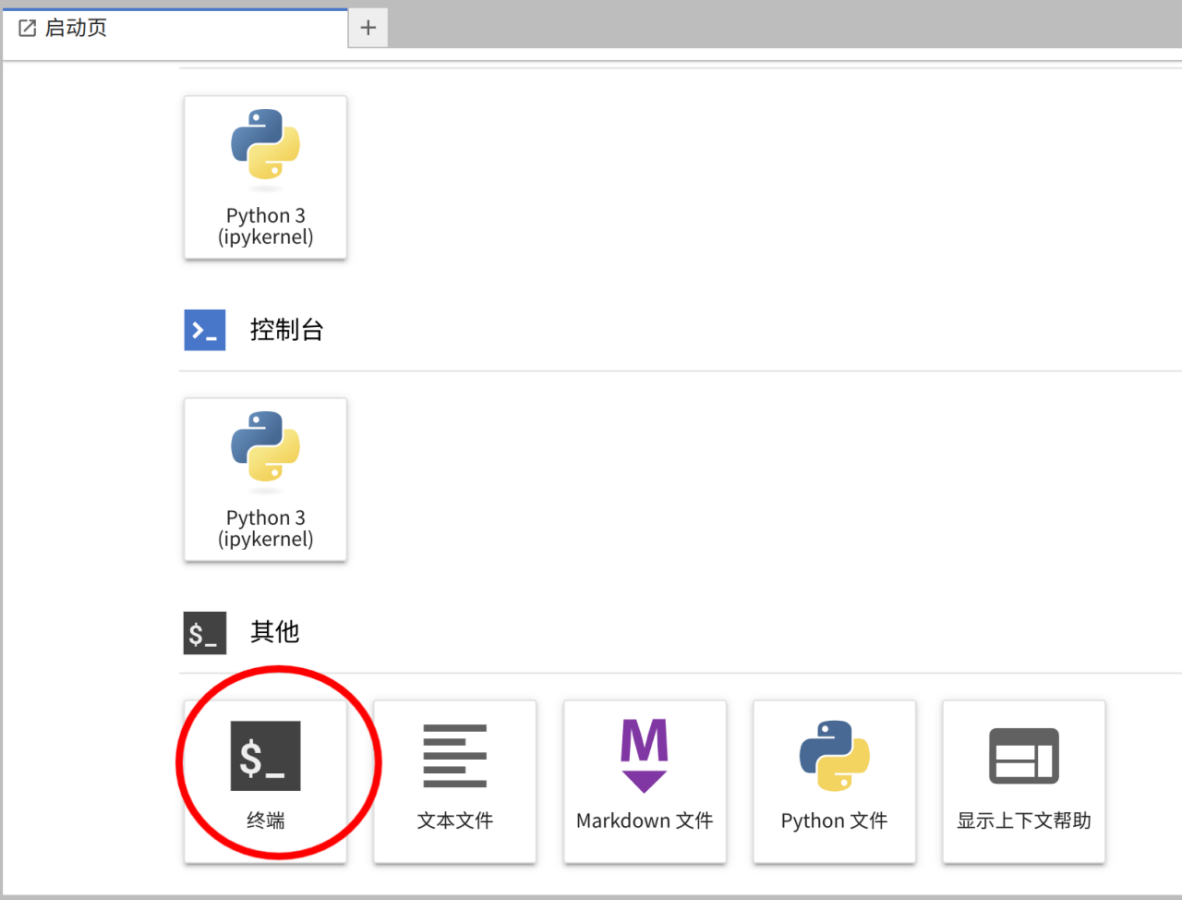
新建终端。
在 JupyterLab 中,点击 "Terminal"(终端)创建新终端。
-
验证环境。
在终端中执行以下命令验证 Python 环境:
python --version
3.4 检查 MUSA 环境
在进行正式的训练流程之前,首先需要检查设备是否支持 MUSA GPU 加速:
-
执行环境检查脚本。
python check_musa.py -
验证输出结果。
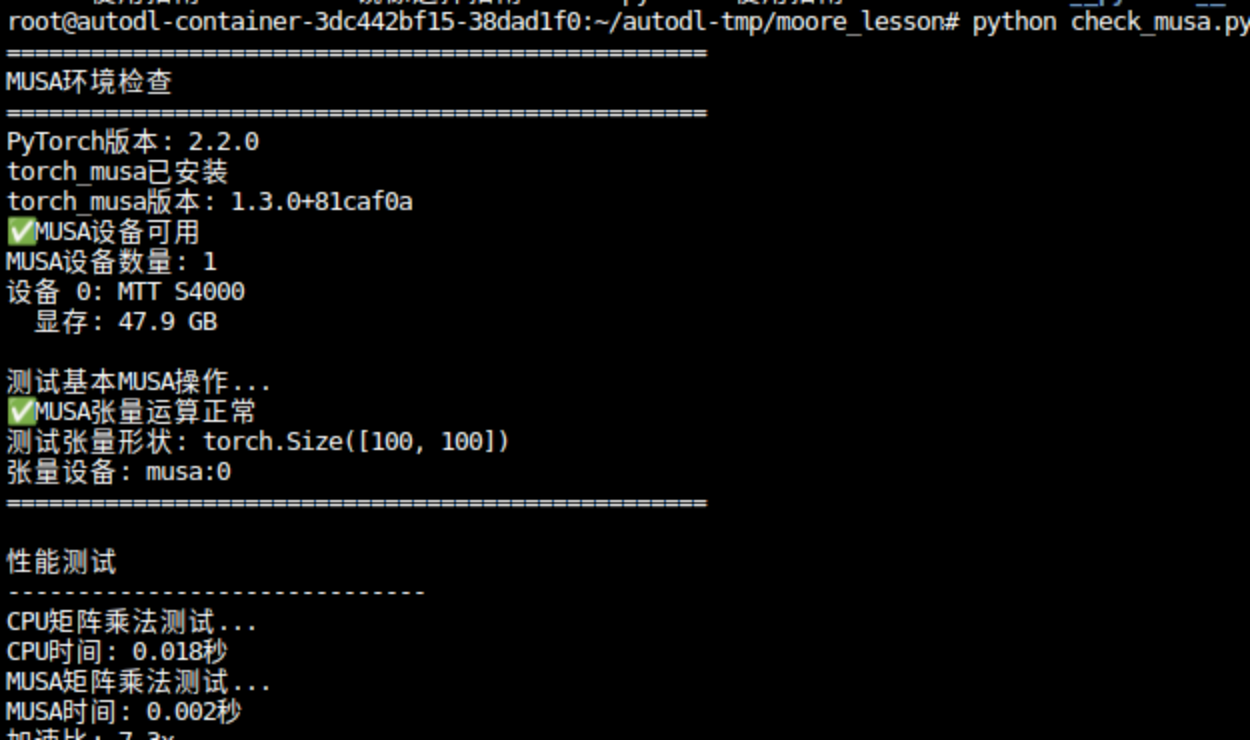
如果成功,终端将输出类似以下信息:
==================================================MUSA 环境检查==================================================PyTorch 版本:2.2.0torch_musa 已安装torch_musa 版本:1.3.0+81caf0a✅ MUSA 设备可用MUSA 设备数量:1设备 0: MTT S4000显存:47.9 GB测试基本 MUSA 操作...✅ MUSA 张量运算正常测试张量形状:torch.Size([100, 100])张量设备:musa:0性能测试------------------------------CPU 矩阵乘法测试...CPU 时间:0.018 秒MUSA 矩阵乘法测试...MUSA 时间:0.002 秒加速比:7.3x这表明系统已正确识别 MUSA GPU 设备。
代码解析:
def get_device_info():
    """检测可用的计算设备"""
    import torch
    import platform

    if torch.musa.is_available():
        device = torch.device('musa')
        device_name = torch.musa.get_device_name(0)
        memory = torch.musa.get_device_properties(0).total_memory // 1024**2
        return f"GPU: {device_name} ({memory}MB)"
    else:
        return "CPU: " + platform.processor()
这段代码会自动检测系统是否支持 MUSA GPU 加速,如果检测到 GPU,会显示设备名称和显存大小。
3.5 安装中文字体(可选)
由于 AutoDL 上的虚拟机默认没有中文字体,如果需要显示中文图表,需要安装中文字体:
-
执行字体安装脚本。
bash setup_fonts.sh -
验证字体安装。
python font_config.py如果输出显示字体配置成功,说明中文字体已正确安装。
4. 最佳实践
本章节指导您完成 CIFAR-10 图像分类项目的核心操作流程。
场景 1: 数据探索与预处理
了解 CIFAR-10 数据集并进行预处理:
-
数据集特点。
- 训练集:50,000 个图像
- 测试集:10,000 个图像
- 类别数:10 个类别(飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船、卡车)
- 图像尺寸:32×32 像素 RGB 彩色图像
-
数据预处理代码示例。
# 数据集会在首次运行时自动下载到 ./data 目录transform = transforms.Compose([transforms.ToTensor(),transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])trainset = torchvision.datasets.CIFAR10(root='./data', train=True,download=True, transform=transform)
场景 2: 模型设计与训练
本项目提供了 CNN 和 ResNet 两个模型架构供用户参考和学习。
1. 使用简单 CNN 模型训练
-
执行训练命令。
python train_cifar10.py --epochs 5 --batch-size 64此命令将使用默认的 SimpleCNN 模型进行训练。
-
模型架构说明。
- 卷积层:自动提取图像的局部特征(如边缘、纹理)
- 池化层:降低特征维度,减少计算量
- 全连接层:输出分类结果
SimpleCNN 模型代码:
class SimpleCNN(nn.Module):"""简单的 CNN 网络,适合 CIFAR-10 分类"""def __init__(self, num_classes=10):super(SimpleCNN, self).__init__()# 卷积层self.conv1 = nn.Conv2d(3, 32, kernel_size=3, padding=1)self.conv2 = nn.Conv2d(32, 64, kernel_size=3, padding=1)self.conv3 = nn.Conv2d(64, 128, kernel_size=3, padding=1)# 池化层self.pool = nn.MaxPool2d(2, 2)# 全连接层self.fc1 = nn.Linear(128 * 4 * 4, 512)self.fc2 = nn.Linear(512, 256)self.fc3 = nn.Linear(256, num_classes)# Dropout 层self.dropout = nn.Dropout(0.5)def forward(self, x):# 卷积 + 激活 + 池化x = self.pool(F.relu(self.conv1(x)))x = self.pool(F.relu(self.conv2(x)))x = self.pool(F.relu(self.conv3(x)))# 展平x = x.view(-1, 128 * 4 * 4)# 全连接层x = F.relu(self.fc1(x))x = self.dropout(x)x = F.relu(self.fc2(x))x = self.dropout(x)x = self.fc3(x)return x
2. 使用 ResNet 模型训练
-
执行训练命令。
python train_cifar10.py --model simple_resnet --epochs 10此命令将使用更复杂的 ResNet 模型进行训练。
-
模型对比。
用户可以自行运行上述对应的模型代码,对比两种模型架构的训练效果和收敛速度差异。
ResNet 模型代码:
class ResNetBlock(nn.Module):"""ResNet 基本块"""def __init__(self, in_channels, out_channels, stride=1):super(ResNetBlock, self).__init__()self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=3,stride=stride, padding=1, bias=False)self.bn1 = nn.BatchNorm2d(out_channels)self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3,stride=1, padding=1, bias=False)self.bn2 = nn.BatchNorm2d(out_channels)# 残差连接self.shortcut = nn.Sequential()if stride != 1 or in_channels != out_channels:self.shortcut = nn.Sequential(nn.Conv2d(in_channels, out_channels, kernel_size=1,stride=stride, bias=False),nn.BatchNorm2d(out_channels))def forward(self, x):out = F.relu(self.bn1(self.conv1(x)))out = self.bn2(self.conv2(out))out += self.shortcut(x)out = F.relu(out)return out
场景 3: 训练过程监控与分析
-
实时训练监控。训练过程中会显示以下信息:
- 每个 epoch 的损失值变化
- 训练和验证准确率
- GPU 利用率和内存占用
- 预计剩余时间
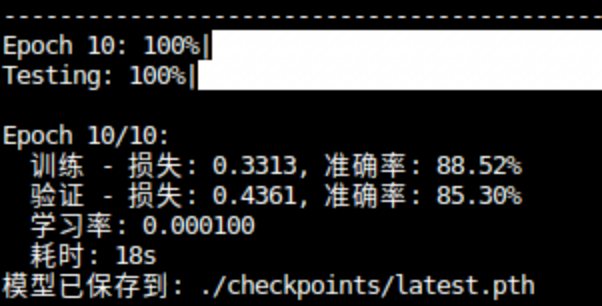
-
查看训练结果。
执行 10 回合的训练后,可以看到模型准确率明显上升。
-
可视化分析。训练完成后会自动生成以下文件:
training_curves.png:损失和准确率曲线图。 模型参数保存在checkpoints/目录。
场景 4: 模型推理与性能测试
1. 基础推理测试
重要提示: 推理时使用的模型类型必须与训练时一致。
-
如果训练时使用 CNN 模型:
python inference.py --model simple_cnn -
如果训练时使用 ResNet 模型:
python inference.py --model simple_resnet
2. 性能基准测试
执行性能基准测试(同样需要确保模型类型一致):
-
如果训练时用的是 CNN:
python inference.py --model simple_cnn --benchmark --visualize -
如果训练时用的是 ResNet:
python inference.py --model simple_resnet --benchmark --visualize
性能指标分析:
- 推理速度:单张图片处理时间
- 批处理性能:不同 batch_size 的吞吐量
- 内存占用:峰值 GPU 内存使用量
- 准确率分析:各类别预测精度对比
场景 5: CPU vs GPU 性能对比
通过对比 CPU 和 GPU 训练性能,体验 GPU 加速的显著优势:
-
CPU 训练基准。
# 强制使用 CPU 训练(用于对比)unset MUSA_VISIBLE_DEVICESpython train_cifar10.py --epochs 2 -
GPU 加速测试。
# 使用 GPU 加速训练python train_cifar10.py --epochs 2 -
性能对比分析。
通过对比训练时间、内存占用、功耗等指标,可以明显感受到 GPU 加速的显著优势。
Epoch 1 输出示例:
开始训练...--------------------------------------------------Epoch 1: 100%|██████████████████████████████|Testing: 100%|██████████████████████████████|Epoch 1/10:训练 - 损失:1.4106, 准确率:48.18%验证 - 损失:1.1446, 准确率:59.74%学习率:0.001000耗时:19s✅ 新的最佳准确率:59.74%模型已保存到:./checkpoints/latest.pth模型已保存到:./checkpoints/best.pth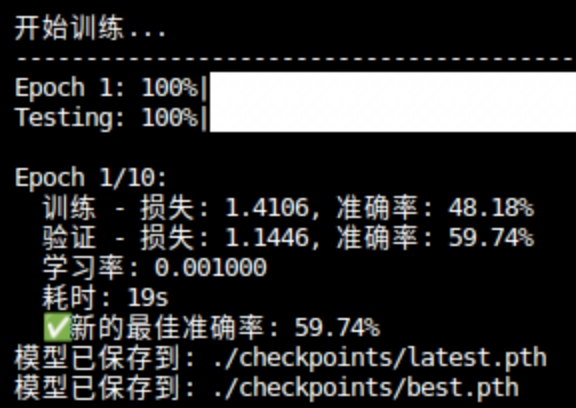
场景 6: 模型超参数调优
超参数是指在训练前需要人为设定的参数,如学习率、批次大小、训练轮数等。合理调整这些参数可以显著影响模型的训练速度和最终效果。
1. 关键超参数说明
| 超参数 | 说明 | 影响 |
|---|---|---|
| 学习率(--lr) | 控制每次参数更新的步长 | 过大可能导致训练不收敛,过小则收敛速度慢,甚至陷入局部最优。 |
| 批次大小(--batch-size) | 每次前向/反向传播所用的样本数 | 大批次训练更稳定、速度快,但显存占用高;小批次有助于跳出局部最优,但训练波动大。 |
| 训练轮数(--epochs) | 数据集被完整训练的次数 | 轮数过少模型欠拟合,过多可能过拟合。 |
2. 超参数调优示例
-
默认参数训练。
python train_cifar10.py -
调大学习率和批次大小,减少训练轮数。
python train_cifar10.py --lr 0.01 --batch-size 256 --epochs 10 -
减小学习率,增加训练轮数。
python train_cifar10.py --lr 0.0005 --batch-size 64 --epochs 30
3. 调优建议
- 学习率调优:先用较大步长(如 0.01)快速试验,找到大致可行范围,再细调(如 0.001、0.0005)。
- 观察训练曲线:观察训练/验证损失和准确率曲线,防止过拟合或欠拟合。
- 批次大小选择:批次大小受限于 GPU 显存,建议在 64~256 之间尝试。
常用操作命令
| 操作 | 命令 |
|---|---|
| 检查 MUSA 环境 | python check_musa.py |
| CNN 模型训练 | python train_cifar10.py --epochs 5 --batch-size 64 |
| ResNet 模型训练 | python train_cifar10.py --model simple_resnet --epochs 10 |
| CNN 模型推理 | python inference.py --model simple_cnn |
| ResNet 模型推理 | python inference.py --model simple_resnet |
| 性能基准测试 | python inference.py --model [模型类型] --benchmark --visualize |
| CPU 训练对比 | unset MUSA_VISIBLE_DEVICES && python train_cifar10.py --epochs 2 |
| 安装中文字体 | bash setup_fonts.sh |
5. 附录
5.1 项目亮点
-
国产全功能 GPU 实战体验:本项目专为体验摩尔线程 GPU 而打造,通过实战可真实感受国产 AI 硬件的训练与推理加速效果。
-
一键适配 AutoDL 与本地环境:项目结构和脚本设计兼容 AutoDL 云平台和本地开发环境,用户可无缝迁移、快速上手,体验云端与本地协同开发。
-
完整深度学习项目流程:涵盖数据下载、模型构建、训练、推理、评估、可视化等全流程,帮助用户系统性掌握 AI 项目开发的每个环节。
5.2 核心知识点
本项目核心涉及以下深度学习知识点,每个知识点都直接体现在代码实现和实验流程中:
1. 卷积神经网络(CNN)
卷积神经网络是一种专门处理图像数据的神经网络结构。它通过卷积层自动提取图像的局部特征(如边缘、纹理),再通过多层堆叠逐步学习更复杂的图像结构。池化层则用于降低特征维度,减少计算量。最终,经过全连接层输出分类结果。CNN 因其参数共享和局部连接的特性,非常适合图像分类任务。
2. 交叉熵损失函数
交叉熵损失函数用于衡量模型输出的概率分布与真实标签分布之间的差异。在分类任务中,交叉熵能有效惩罚错误分类的概率预测,推动模型输出更接近真实标签,是图像分类中最常用的损失函数。
3. Adam 优化器
Adam 是一种自适应学习率的优化算法。它结合了动量法和 RMSProp 的优点,能根据每个参数的历史梯度自动调整学习率,从而加快收敛速度并提升训练稳定性。Adam 在深度学习项目中应用广泛,尤其适合大规模数据和参数的优化。
4. 数据增强
数据增强是通过对原始图片进行旋转、翻转、裁剪等操作,生成更多样本,增加训练数据的多样性。这样可以有效防止模型过拟合,提高模型在新数据上的泛化能力。
5. PyTorch 数据管道(Dataset & DataLoader)
PyTorch 的 Dataset 和 DataLoader 模块负责高效地加载和批量处理数据。Dataset 定义了数据的读取和预处理方式,DataLoader 则实现了批量加载、打乱顺序和多线程加速,极大提升了训练效率。
6. GPU 加速(MUSA)
本项目支持 MUSA 的 GPU 加速技术。通过将数据和模型运算转移到 GPU 上,可以利用其强大的并行计算能力,大幅提升模型训练和推理速度,尤其适合大规模神经网络。
7. 模型评估指标(准确率、混淆矩阵)
准确率是分类任务中最常用的评估指标,表示预测正确的样本占总样本的比例。混淆矩阵则详细展示了每个类别的预测情况,帮助分析模型在哪些类别上表现较好或较差。
8. 训练与验证流程
训练流程包括前向传播、损失计算、反向传播和参数更新。验证流程则是在训练过程中定期用未见过的数据评估模型性能,帮助监控过拟合和模型泛化能力。
5.3 常见问题
| 问题描述 | 可能原因 | 解决方案 |
|---|---|---|
| MUSA 环境检测失败 | GPU 驱动未正确安装或设备不可用 | 1. 检查实例配置:确认选择了摩尔线程专区 2. 验证镜像:确认使用了支持 MUSA 的镜像 3. 重新启动实例。 |
| 训练时出现 OOM(内存不足) | 批次大小过大或模型参数过多 | 1. 减小批次大小:--batch-size 322. 使用更小的模型 3. 启用混合精度训练。 |
| 数据集下载失败或速度慢 | 网络连接问题或下载源不可用 | 1. 检查网络连接 2. 使用镜像源或手动下载数据集 3. 将数据集上传到实例存储。 |
| 推理时模型类型不匹配 | 训练和推理使用了不同的模型架构 | 1. 确认训练时使用的模型类型 2. 推理时使用相同的 --model 参数3. 检查模型文件路径。 |
| 训练准确率不提升 | 学习率设置不当或模型架构问题 | 1. 调整学习率:尝试不同的学习率值 2. 增加训练轮数 3. 检查数据预处理是否正确。 |
| 可视化图表中文显示乱码 | 未安装中文字体 | 1. 执行 bash setup_fonts.sh 安装字体2. 验证字体安装: python font_config.py。 |
| AutoDL 实例无法访问 | 实例未启动或网络问题 | 1. 检查实例状态:确认实例已启动 2. 刷新页面或重新登录 3. 检查网络连接。 |
5.4 相关资源
AutoDL 平台官网:https://www.autodl.com/
CIFAR-10 数据集官方页面:https://www.cs.toronto.edu/~kriz/cifar.html
PyTorch 官方文档:https://pytorch.org/docs/stable/index.html
摩尔线程 GPU 技术文档:了解 MUSA 加速技术详情
深度学习入门教程:推荐《动手学深度学习》等经典教材